已實現波動率換一把更貴的尺,答案沒變;換一個衡量對象,名次整個翻掉
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
做量化的人常花很多力氣在挑模型,卻很少花力氣在挑「用什麼東西來評分」。
我們拿 SPY 的五分鐘資料重做了一次這件事,資料期間 2026-01-14 到 2026-04-10,共 58 個交易日。原本想回答的問題很技術:五分鐘一根的資料,會不會因為買賣價差來回跳動而把波動量得偏高?學界對這件事有一套修正工具(核估計法,Barndorff-Nielsen 等人 2008 年提出),比標準算法貴、也複雜得多。
結果是:對這段 SPY 資料,那把貴的尺沒有量出不一樣的東西。
但同一份實驗裡跑出了另一件事,比原本的問題有用得多。
貴的尺沒有量出不一樣的東西
把標準算法和核估計法逐日擺在一起比,兩者相關係數 0.7559。標準算法量出來比較高的日子占 63.79%,看起來像是有點偏高的傾向;可是把每天的差距做配對檢定,p 值 0.8732,完全談不上系統性差距。中位數的相對差距是 8.43%,方向不穩定,日與日之間互有高低。
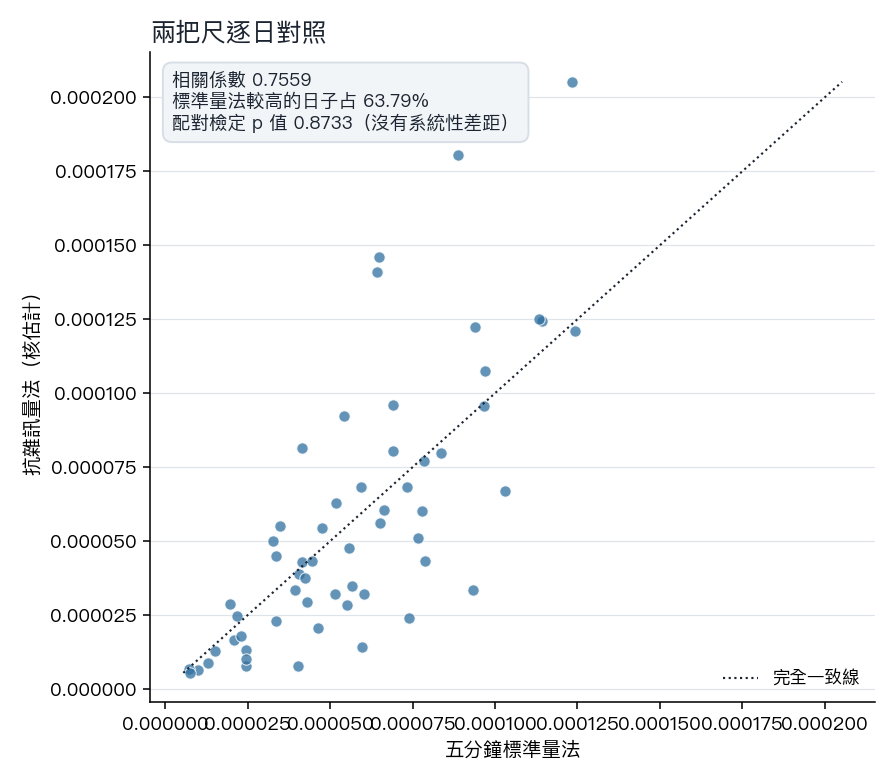
換句話說,SPY 這種全世界成交最熱絡的標的,在五分鐘這個頻率上,買賣價差造成的雜訊小到量不出來。
這對一般投資人有個直接的意涵:如果你在算自己部位的已實現波動率,用最陽春的五分鐘平方和就夠了,不必去追那些聽起來很厲害的修正方法。省下來的力氣該花在別的地方。
花在哪裡?花在你拿什麼當標準答案
實驗的第二段,把三個常見的波動率預測模型放在一起評分。三個模型分別是:只用價格歷史的日內高頻模型、傳統的條件波動模型、以及靠選擇權市場定價當外部訊號的模型。
評分要有標準答案,也就是「當天實際波動到底是多少」。而「實際波動」本身就要用某把尺量出來。實驗用了四把:五分鐘標準量法、抗雜訊量法、子網格平均量法,以及最粗糙的一把,只用當天收盤對收盤的漲跌幅平方。
前三把尺量出來的名次完全一樣,都是日內高頻模型第一、傳統條件波動模型第二、選擇權定價驅動模型第三。
換到第四把尺,名次整個倒過來:選擇權定價驅動模型第一、傳統條件波動模型第二、日內高頻模型墊底。
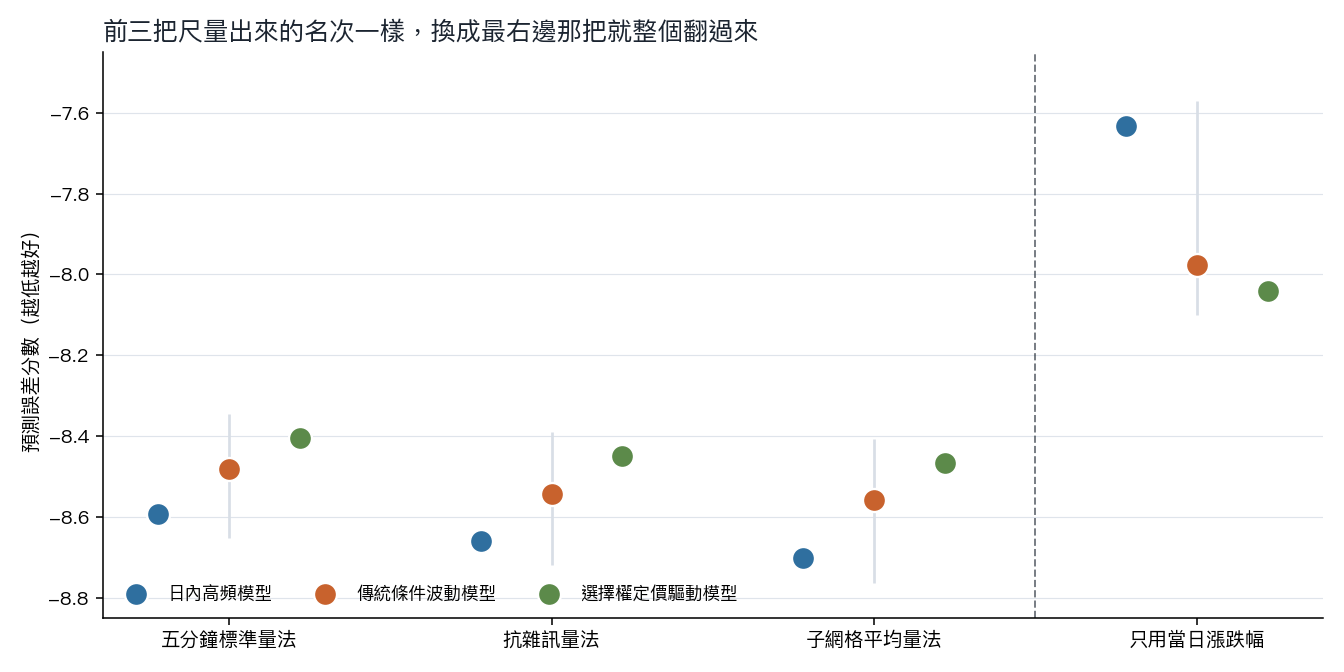
同一批模型、同一段行情、同一個評分公式,只因為標準答案換了一把尺,冠軍變墊底。
為什麼會這樣
只用當日漲跌幅當標準答案,等於用一個極度粗糙的觀測值去猜當天真正的波動程度。它沒有錯,只是很吵。一個模型如果預測值本身比較平滑、比較保守,在很吵的標準答案面前反而占便宜,因為它不會被單日的噪音懲罰得太重。反過來,日內高頻模型的優勢正是它抓得到當天盤中真正發生的事,這個優勢在粗糙的尺面前完全發揮不出來。
這裡要講清楚一件事,免得被誤讀:這個翻轉是評分工具和模型目標對不上造成的,不是選擇權定價驅動模型突然變強了。日內高頻模型預測的本來就是盤中波動,拿全日漲跌幅去給它打分數,等於用錯的考卷考它。我們自己的研究版文章早就把這個現象標記為評分錯配,不是預測能力的真實翻轉。
之所以還是值得對一般讀者講,是因為讀者看到的通常只有名次,看不到那張考卷長什麼樣。
這件事在實務上怎麼用
你大概不會自己去估模型,但你會看到別人估的結果。看到「某某模型打敗某某模型」的說法時,值得多問一句:他們拿什麼當標準答案。
- 如果標準答案是日內高頻資料算出來的,比較的是「誰更會抓當天的實際波動」。
- 如果標準答案是日報酬平方,比較的是「誰在很吵的環境下猜得比較穩」。
這是兩個不同的問題,答案本來就可以不一樣。用其中一個的結論去推銷另一個的用途,就是把名次當成了真理。
同樣的邏輯也適用於你自己的績效檢視。用不同的區間、不同的基準去量同一套操作,排名會跟著換。名次會動,不代表操作本身有變。
這份證據的邊界
必須把話說清楚,這是一份初步結果,不是定論:
| 項目 | 數字 |
|---|---|
| 資料期間 | 2026-01-14 到 2026-04-10 |
| 交易日數 | 58 |
| 用於評分的樣本外天數 | 28 |
| 標的 | 僅 SPY 一檔 |
| 兩把尺的相關係數 | 0.7559 |
| 配對檢定 p 值 | 0.8732 |
28 天的樣本外期間,對「模型 A 是否真的優於模型 B」這種問題來說太短,做嚴格的統計比較大多數組合都達不到顯著。要下定論,一般需要一年以上的樣本外天數。
也只測了 SPY 一檔。流動性差的標的、成交稀疏的個股或小型 ETF,五分鐘資料的雜訊問題可能真的存在,這份結果不能外推過去。
但「換一把尺會換一個名次」這件事,本身不需要更長的樣本才成立。它在 28 天裡就看得一清二楚,而且它是結構性的,不是抽樣運氣。
懶人包圖組
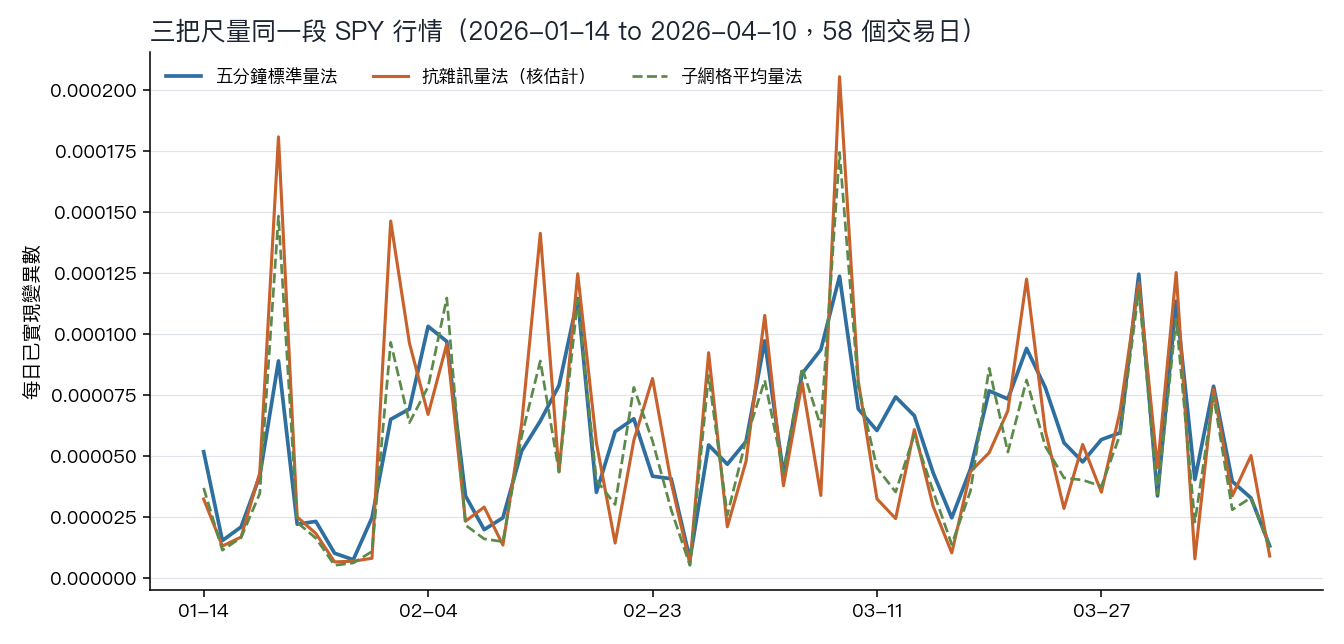
完整結果、腳本與四張原始圖表存放在實驗紀錄 experiments/k1072/,含每日估計值與所有比較檢定的原始輸出。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊