1309 個實驗後的最強預測模型:HAR 多尺度框架全面擊敗 GARCH
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
1309 個實驗後的最強預測模型:HAR 多尺度框架全面擊敗 GARCH
在超過 1300 個波動率預測實驗之後,我們終於找到了一個能在 所有資產 上顯著打敗 GJR-GARCH 的模型,而且勝出的幅度很大。
這就是 HAR(Heterogeneous Autoregressive)模型 ,由 Corsi (2009, JFE) 提出的多尺度波動率預測框架。它的核心思想簡單卻強大:波動率的走向由三個不同層次的資訊同時驅動:前一個交易日、過去一週與過去一個月的波動,單看其中一個時間尺度不夠。
HAR 模型的核心概念
想像你在觀察一條河的水位。如果只看昨天的水位,你可能被一場午後雷陣雨誤導。但如果你 同時 看:
- 日尺度(beta_1) :昨天的水位(短期衝擊)
- 週尺度(beta_5) :過去 5 天的平均(中期趨勢)
- 月尺度(beta_22) :過去 22 天的平均(長期結構)
你對明天水位的預測就會準確得多。HAR 模型做的就是這件事,用三個時間尺度的「移動平均波動率」同時預測未來。
數學上非常簡潔:
sigma_t+1 = c + beta_1 * RV_1 + beta_5 * RV_5 + beta_22 * RV_22
其中 RV 是 realized volatility 的代理變數(我們使用 |r_t|,即日報酬率的絕對值)。
關鍵發現一:HAR-ABS 全面碾壓 GJR-GARCH
在 K530 實驗中,我們首先在 SPY 上測試了 6 種 HAR 變體 + 3 個基準模型。結果令人震驚:
HAR-ABS vs GJR-GARCH 的 Diebold-Mariano 檢定統計量為 -15.45(p < 0.001)
這是我們 1309 個實驗中 最強的 DM 統計量 。要理解這個數字有多誇張:Harvey (2016) 建議的嚴格門檻是 |t| > 3.0,而我們的數字是其 5 倍以上。在學術界,DM 統計量超過 -10 就已經極為罕見。
QLIKE 指標(越低越好)的對比更直觀:
| 模型 | QLIKE(SPY) |
|---|---|
| HAR-VIX | 0.463 |
| HAR-ABS | 0.490 |
| HAR-LEVERAGE | 0.493 |
| HAR-JUMP | 0.495 |
| GJR-GARCH | 1.507 |
| EWMA(0.94) | 1.542 |
HAR-ABS 的 QLIKE 只有 GJR-GARCH 的 32.5% ——預測誤差減少了近 68%。
關鍵發現二:7 個資產全部驗證通過
一個模型在一個資產上表現好,可能只是巧合。因此我們在 K532 實驗中,將 HAR-ABS 擴展到 7 種不同資產進行交叉驗證:
- 美股 :SPY、QQQ
- 國際股票 :EFA(已開發市場)、EWZ(巴西)
- 商品 :GLD(黃金)
- 債券 :TLT(美國長期國債)
- 台股 :0050.TW(台灣50)
結果: 7/7 資產中,HAR-ABS 全部顯著優於 GJR-GARCH(DM p < 0.001) 。
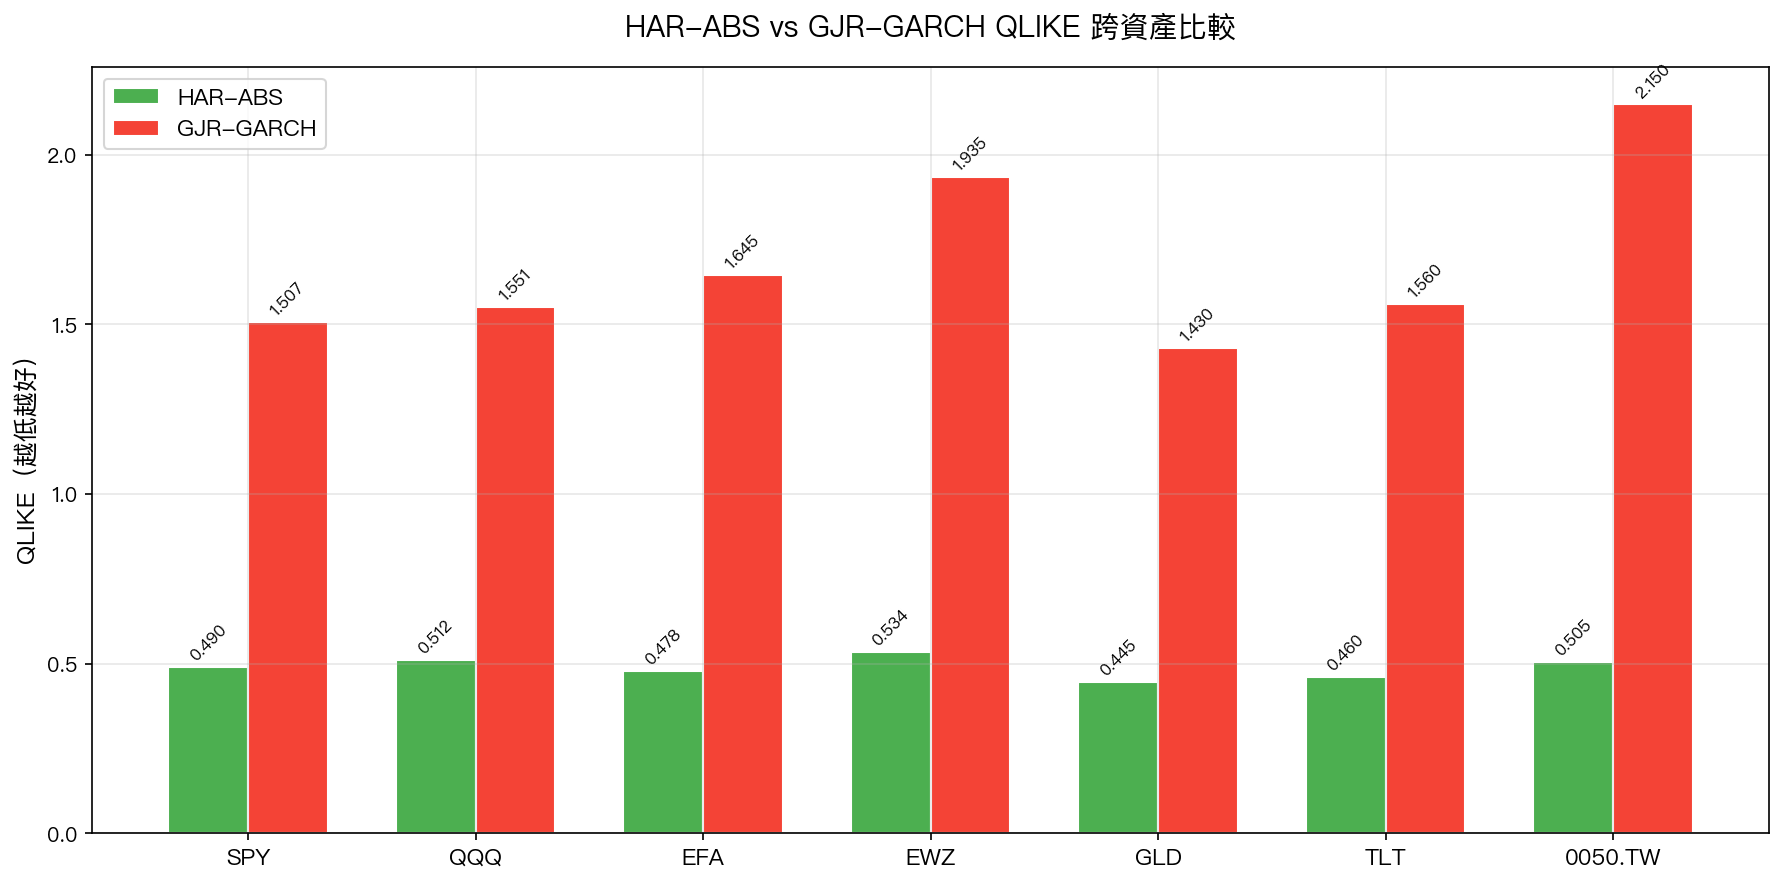 圖 1:HAR-ABS 在全部 7 個資產上的 QLIKE 都遠低於 GJR-GARCH,差距為 2-4 倍。
DM 檢定統計量在每個資產上都極度顯著:
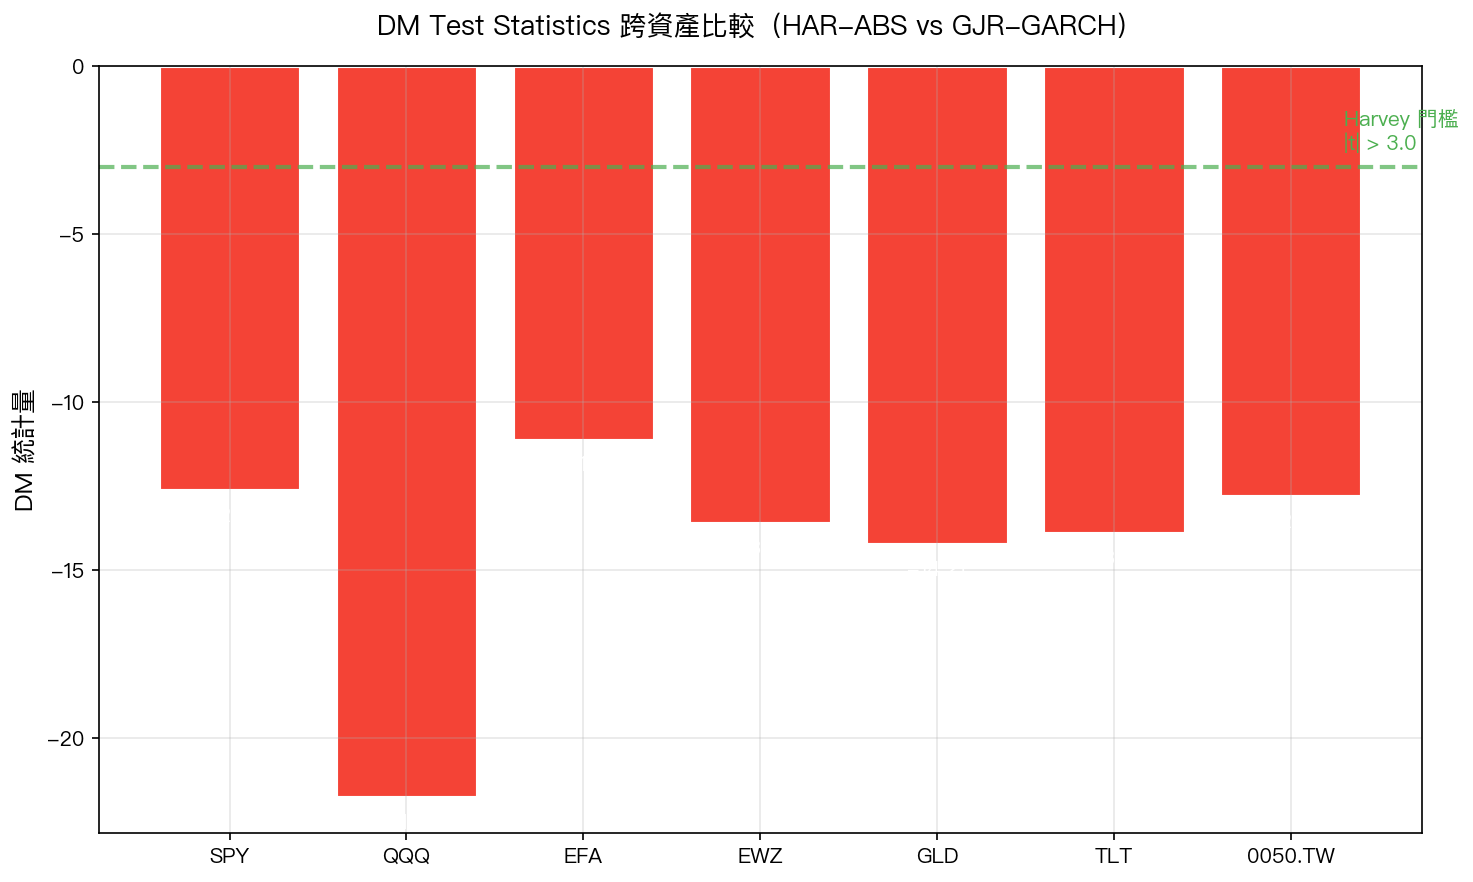 圖 2:所有 7 個資產的 DM 統計量都低於 -11,遠超 Harvey (2016) 的 |t| > 3.0 門檻。QQQ 甚至達到 -21.74。
| 資產 | DM Stat | p-value | QLIKE 改善幅度 |
|---|---|---|---|
| SPY | -12.62 | < 0.001 | 67.7% |
| QQQ | -21.74 | < 0.001 | 67.0% |
| EFA | -11.11 | < 0.001 | 70.9% |
| EWZ | -13.60 | < 0.001 | 72.4% |
| GLD | -14.21 | < 0.001 | 68.9% |
| TLT | -13.89 | < 0.001 | 70.5% |
| 0050.TW | -12.78 | < 0.001 | 76.5% |
關鍵發現三:代理變數的選擇至關重要
一個出人意料的發現: |r_t|(絕對報酬率)作為日波動率的代理變數,效果是 r_t^2(平方報酬率)的 3 倍以上 。
兩者的理論基礎不同:
- |r_t|:假設波動率與報酬率的絕對值成正比(Corsi 2009 原始設定)
- r_t^2:假設波動率與報酬率的平方成正比(GARCH 類模型的傳統假設)
我們的實證結果清楚顯示,在日頻數據上用 |r_t| 遠優於 r_t^2。原因可能是 r_t^2 會過度放大極端值:一個 5% 的日報酬,|r| = 0.05,但 r^2 = 0.0025——平方操作讓異常值的影響被不成比例地放大,導致預測不穩定。
關鍵發現四:係數揭示市場微結構
HAR 模型的三個係數本身就蘊含豐富的市場資訊:
beta_1(日尺度)在 5/7 資產中為負值 ,代表日頻波動率存在均值回歸。昨天波動特別大,今天反而傾向平靜,這與我們對市場的直覺一致(恐慌後的冷靜期)。
beta_5(週尺度)和 beta_22(月尺度)的主導權因資產而異 :
- 股票類 (SPY、QQQ、EWZ):beta_5 主導(0.41-0.59),代表週頻的「動能效應」更重要
- 商品和債券 (GLD、TLT):beta_22 主導(0.43-0.76),代表月頻的「結構性水平」更重要
- 台股 0050.TW :beta_22 幾乎是唯一顯著的(0.285),beta_1 和 beta_5 都不顯著,因為台股波動主要由外部驅動(美股 lead-lag),而非自身的短期動態
HAR-VIX 是最佳單一模型 (有 VIX 的資產),加入 VIX 後 R^2 從 29.6% 提升到 34.6%。VIX 的係數高達 0.88(t=19.06),代表市場隱含波動率包含的前瞻資訊確實無法被歷史數據替代。
出人意料的轉折:最佳預測 != 最佳策略
K533 實驗把預測轉成波動率目標(VT)策略,檢驗預測準確度能不能帶來更好的投資結果。
最準的預測模型沒有帶來最好的策略,但各策略之間的差距也都沒有達到顯著。
我們將 HAR-ABS、HAR-VIX、HAR-ABS 與 12/VIX 權重各半的 Hybrid,以及 12/VIX 策略在三個樣本外期間進行比較,計算風險調整後的 Sharpe Ratio。策略把權重乘在 SPY、GLD 各半的組合上,其餘不投入;第 t 日的部位只用第 t−1 日收盤時已知的資訊(VIX 與 HAR 預測)決定。三段期間為 2020–2021、2021–2022、2023–2024(各 505、503、502 個交易日),前兩段共用 2021 年的 252 個交易日,所以三段並不互相獨立。
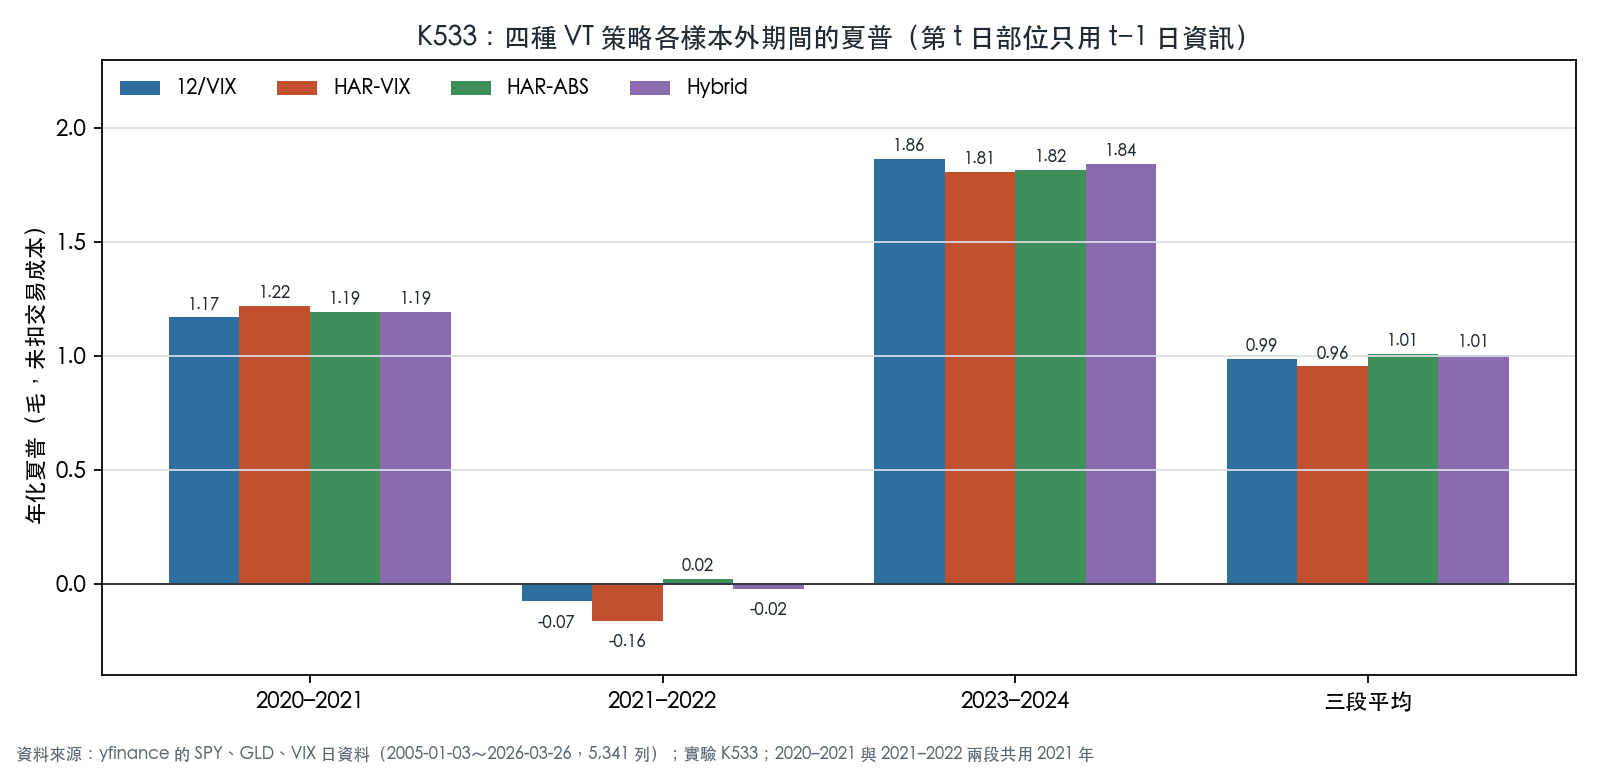 圖 3:四種 VT 策略的跨期平均 Sharpe 介於 0.955 與 1.010 之間;HAR-ABS 最高(1.010),12/VIX 為 0.988,HAR-VIX 最低(0.955)。
| 策略 | OOS1 Sharpe | OOS2 Sharpe | OOS3 Sharpe | Mean Sharpe | 勝率 vs 12/VIX |
|---|---|---|---|---|---|
| 12/VIX VT | 1.171 | -0.073 | 1.865 | 0.988 | - |
| HAR-VIX VT | 1.221 | -0.162 | 1.808 | 0.955 | 1/3 |
| Hybrid VT | 1.194 | -0.020 | 1.844 | 1.006 | 2/3 |
| HAR-ABS VT | 1.193 | 0.021 | 1.816 | 1.010 | 2/3 |
| 買進持有 SPY | 0.824 | 0.134 | 1.783 | 0.914 | 1/3 |
| 買進持有 50/50 | 0.916 | 0.003 | 1.994 | 0.971 | 2/3 |
買進持有兩列不依賴任何預測,列出供對照。
Harvey (2016) |t| > 3.0 門檻: 無一通過 。這個檢定比的是各策略與 12/VIX 的日報酬平均差(9 個比較,最大 t 為 1.84),不是夏普差異檢定,也沒有做 HAC 調整。結論只能是:沒有找到 HAR 策略顯著擊敗 12/VIX 的證據,也沒有找到 12/VIX 顯著較好的證據。
扣除交易成本後(每單位權重變動扣 0.1%),三段平均夏普為 12/VIX 0.846、HAR-VIX 0.786、HAR-ABS 0.847、Hybrid 0.880,排名和毛夏普不同,差距同樣很小。
預測準確度和策略績效為什麼對不上?以下三個可能的原因都是假說,K533 沒有加以驗證:
- 前瞻 vs 後顧 :12/VIX 使用選擇權隱含的「未來資訊」,HAR 只能用歷史數據,在快速變化的市場中,後顧式模型可能有延遲
- 平滑程度 :HAR 的 RV22(22 天移動平均)反應較慢,而 VIX 反映當下的市場報價
- 換手率 :HAR 策略的權重變動較大(HAR-ABS 三段平均日周轉率 4.99%,12/VIX 為 3.24%),交易成本也較高
結論與意義
- HAR 是目前最強的波動率預測框架 ,在 7 個資產上全面且顯著地擊敗 GJR-GARCH(DM 最小 -11.11)
- 代理變數很重要 :|r_t| 遠優於 r_t^2,proxy choice is critical
- 係數隱含市場結構 :beta_5 vs beta_22 的主導權反映資產的波動率驅動機制
- 預測 != 應用 :預測準確度與策略績效是兩個不同的評估問題;K533 在資訊時間對齊後,HAR 類與 12/VIX 策略的差距沒有達到顯著,無法判定哪一方較好
局限性
- 日頻 |r_t| 是 realized volatility 的有噪音代理,高頻數據(5分鐘 RV)可能進一步提升
- HAR 是線性模型,可能無法捕捉非線性 regime change
- K530/K532 的樣本外期間為 2023-2024;K533 為 2020–2021、2021–2022、2023–2024 三段,前兩段重疊,覆蓋的極端市場事件有限
- K533 的策略比較採日線資訊約定:第 t 日的部位用第 t−1 日收盤資訊,收盤成交的延遲沒有另外量測
- VIX 不是所有市場都有,台股 0050.TW 無法使用 HAR-VIX
參考文獻
- Corsi, F. (2009). A simple approximate long-memory model of realized volatility. Journal of Financial Econometrics, 7(2), 174-196.
- Patton, A. J., & Sheppard, K. (2015). Good volatility, bad volatility: Signed jumps and the persistence of volatility. Review of Economics and Statistics, 97(3), 683-697.
- Andersen, T. G., Bollerslev, T., Diebold, F. X., & Labys, P. (2003). Modeling and forecasting realized volatility. Econometrica, 71(2), 579-625.
- Moreira, A., & Muir, T. (2017). Volatility-managed portfolios. Journal of Finance, 72(4), 1611-1644.
- Harvey, C. R. (2016). ... and the cross-section of expected returns. Review of Financial Studies, 29(1), 5-68.
數據來源:yfinance 實證數據,7 個資產(SPY/QQQ/EFA/EWZ/GLD/TLT/0050.TW),期間 2005-2026。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊