一個 +5.06 的漂亮勝利,只要改掉「你幾點做預測」就沒了
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
先說結論的形狀,這樣你讀下去才知道我在追什麼。
我們手上有一個波動率模型,在招牌成績單上以 DM 統計量 +5.06 贏過業界標準的 GJR 模型。統計上這叫壓倒性,一般門檻大概 2 就算過關,嚴格一點的學界標準抓 3。+5.06 是那種不用細看、直接寫進投影片第一頁的數字。
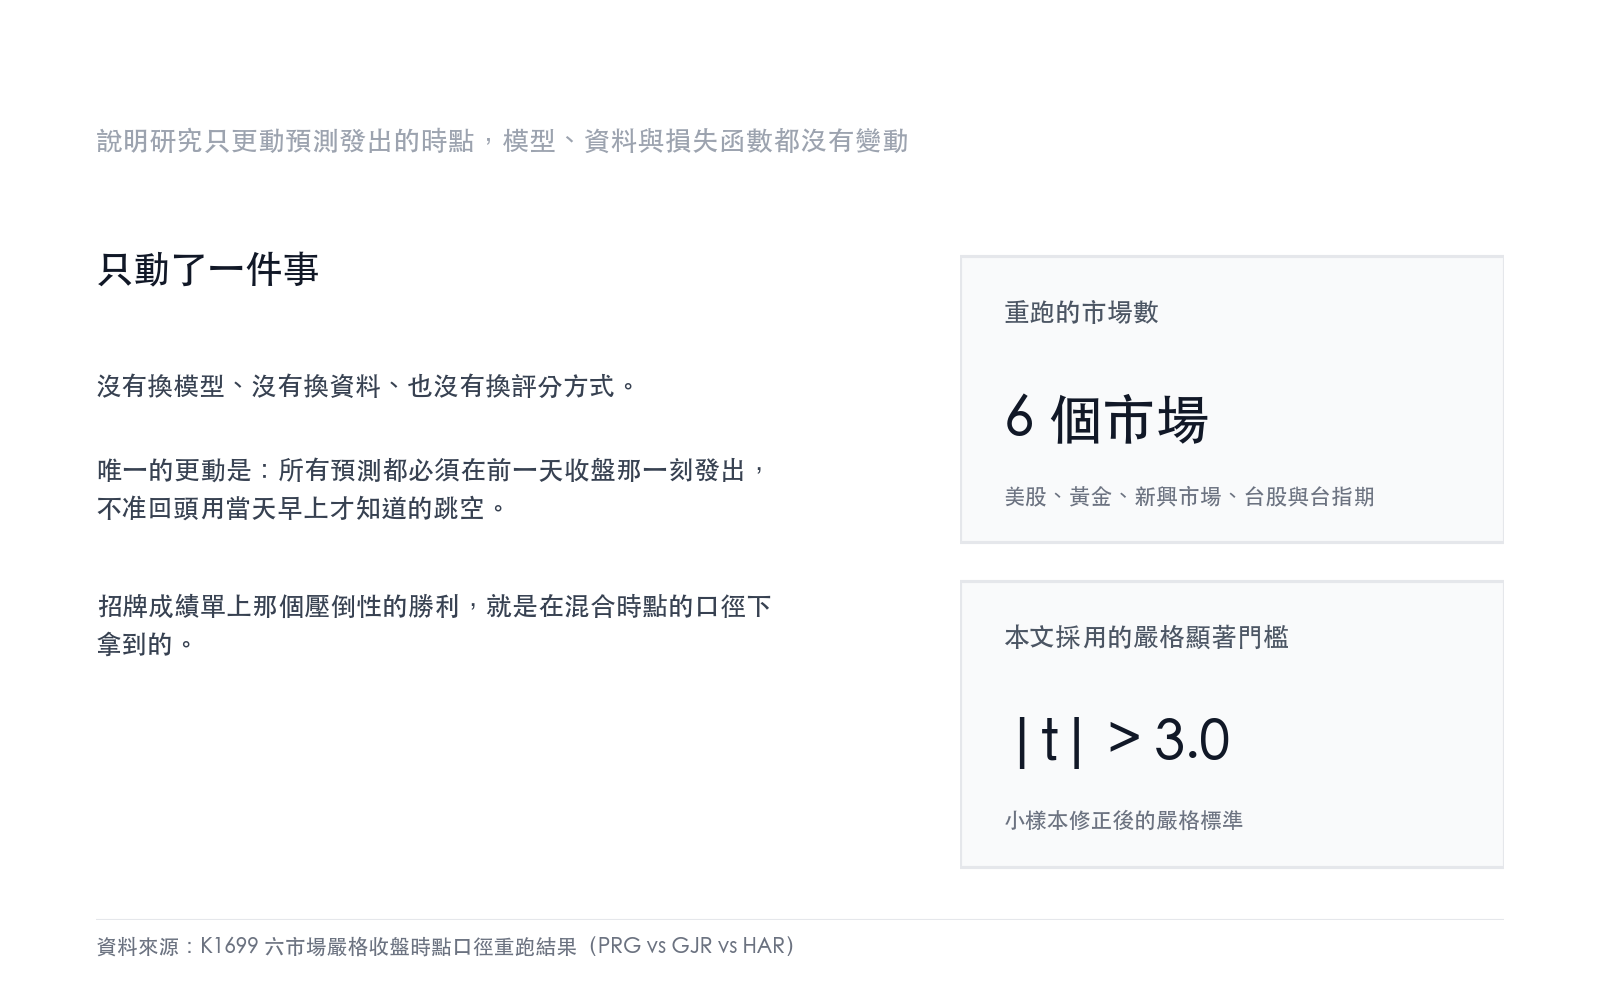
我們沒有換模型,沒有換資料,也沒有換損失函數。只改了一件聽起來像行政細節的事:規定所有預測都必須在「前一天收盤那一刻」發出。
六個市場重跑,DM 統計量落在 −0.54 到 +2.28 之間。零勝六。
「幾點做預測」為什麼會是個問題
波動率模型要預測的是「明天這一整天會震多大」。一整天可以拆兩段:晚上休市到隔天開盤的跳空,加上開盤到收盤的盤中震盪。
那個拿到 +5.06 的模型,賣點就是把這兩段分開建模。理論上很合理,隔夜和盤中的行為本來就不一樣。
問題出在它預測時手上握著什麼。原本的做法在算「今天全日波動」時,用到了今天早上已經發生的跳空幅度。等於中午才預報今天下不下雨,而你早上已經淋過了。
實務上沒有人能這樣操作。你若是每天收盤後要決定明天曝險部位的人,你在按下按鈕的當下,明天早上的跳空還不存在。
所以 K1699 把口徑釘死:預測發出的時點是 t−1 收盤,模型只能看到那一刻之前的資訊,隔夜衝擊用模型自己的期望值填補,不准回頭偷看。GJR 和 HAR 兩個對照組本來就是這樣跑的,現在三個模型站在同一條起跑線上。
六個市場,沒有一個跨得過門檻
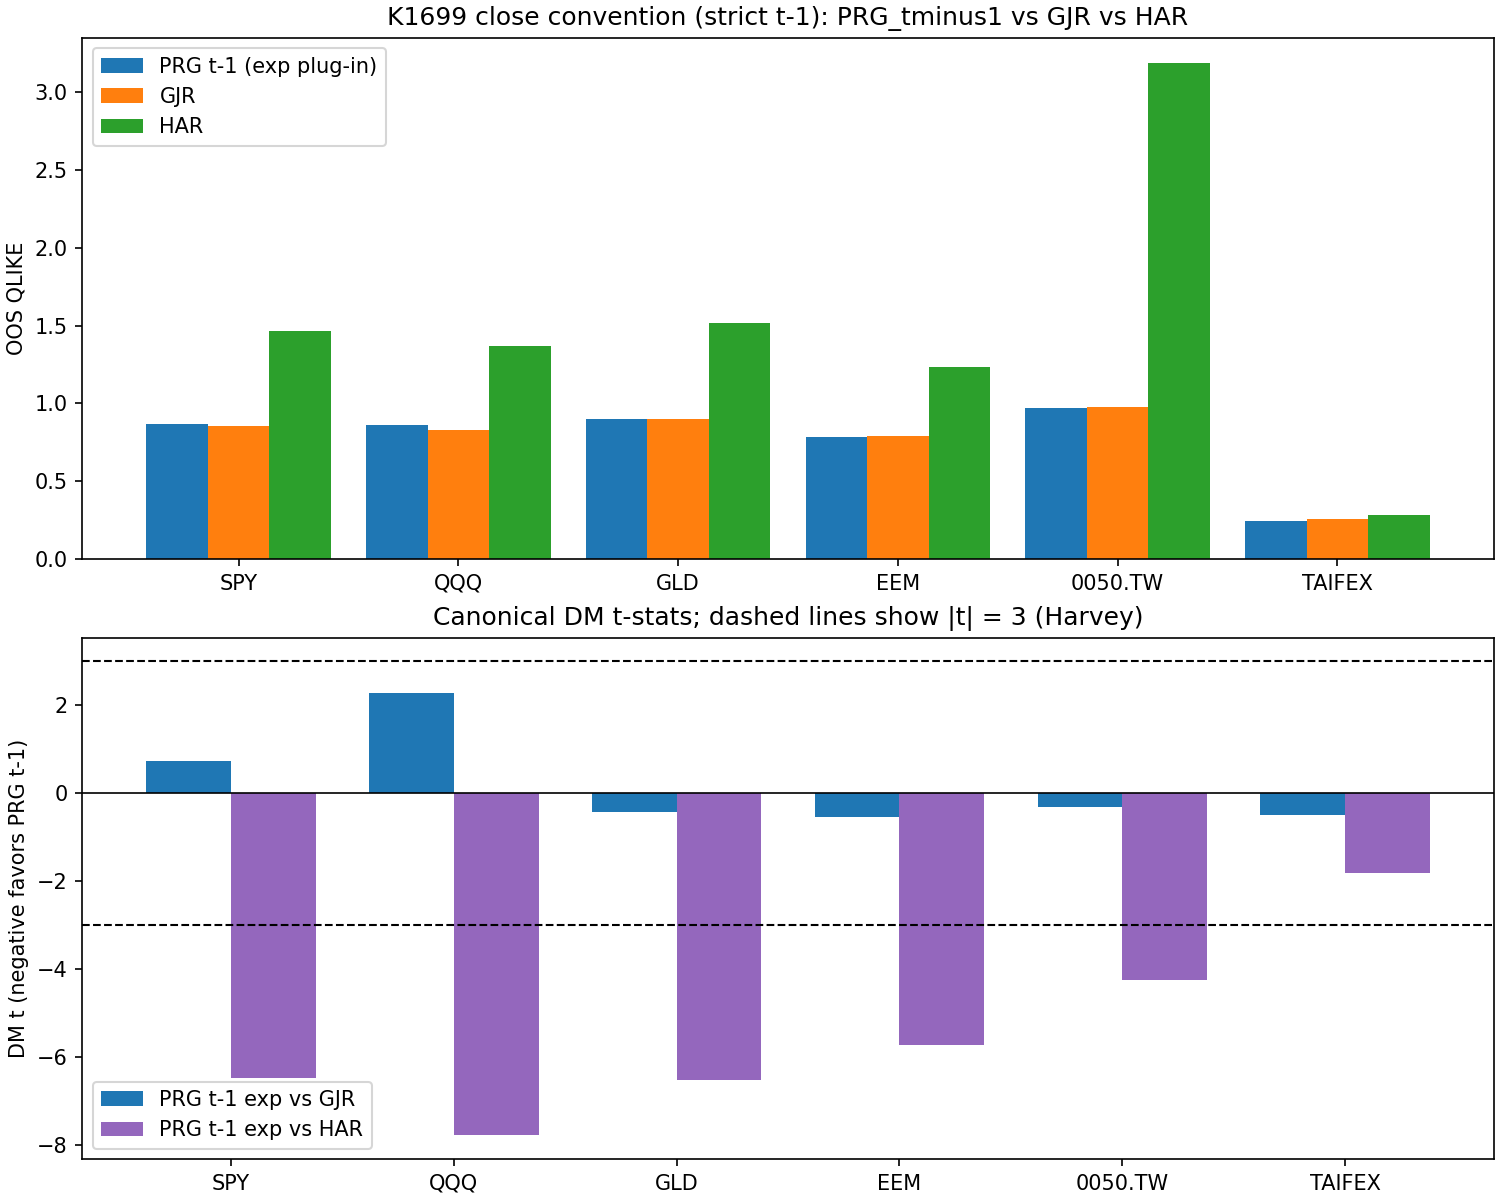
上圖上半部是預測誤差分數(越低越準),下半部是 DM 統計量,兩條虛線是嚴格門檻,統計強度 3。藍柱是新模型對 GJR 的較量,六根全部縮在中間那條窄帶裡。
單獨把 DM 這一欄放大,看得更清楚:
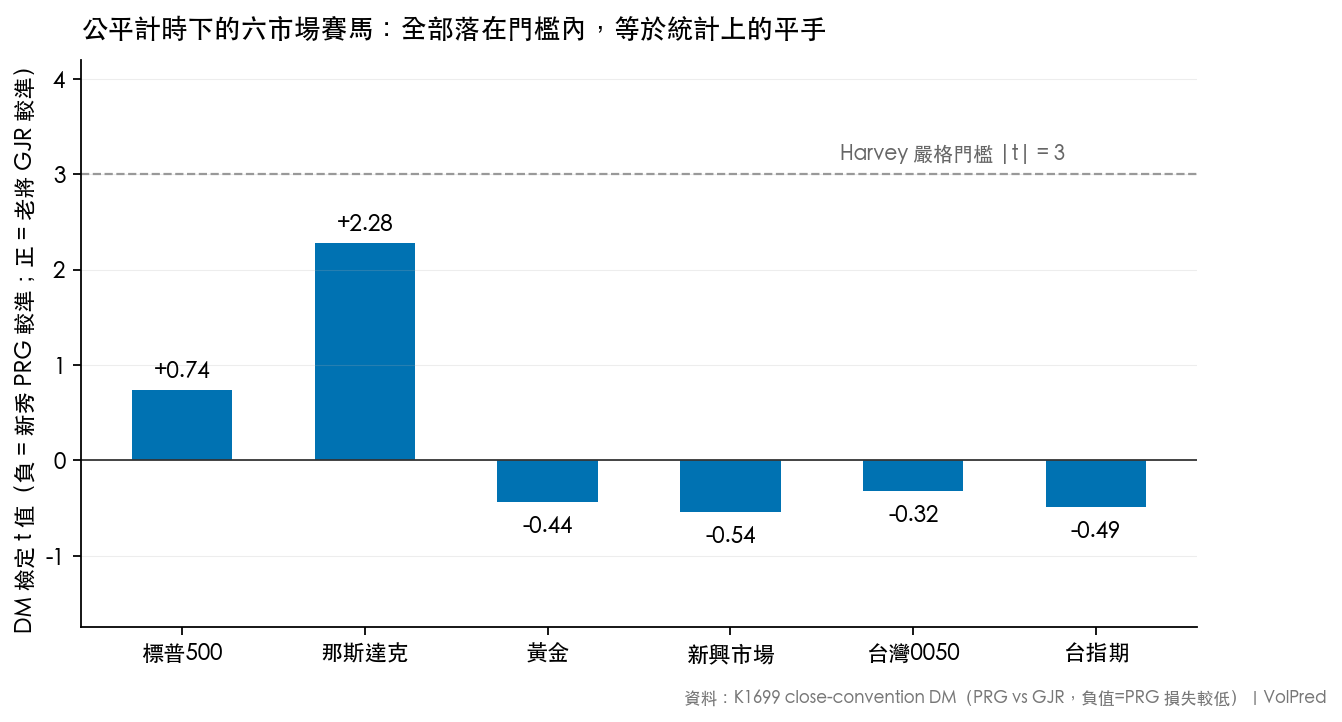
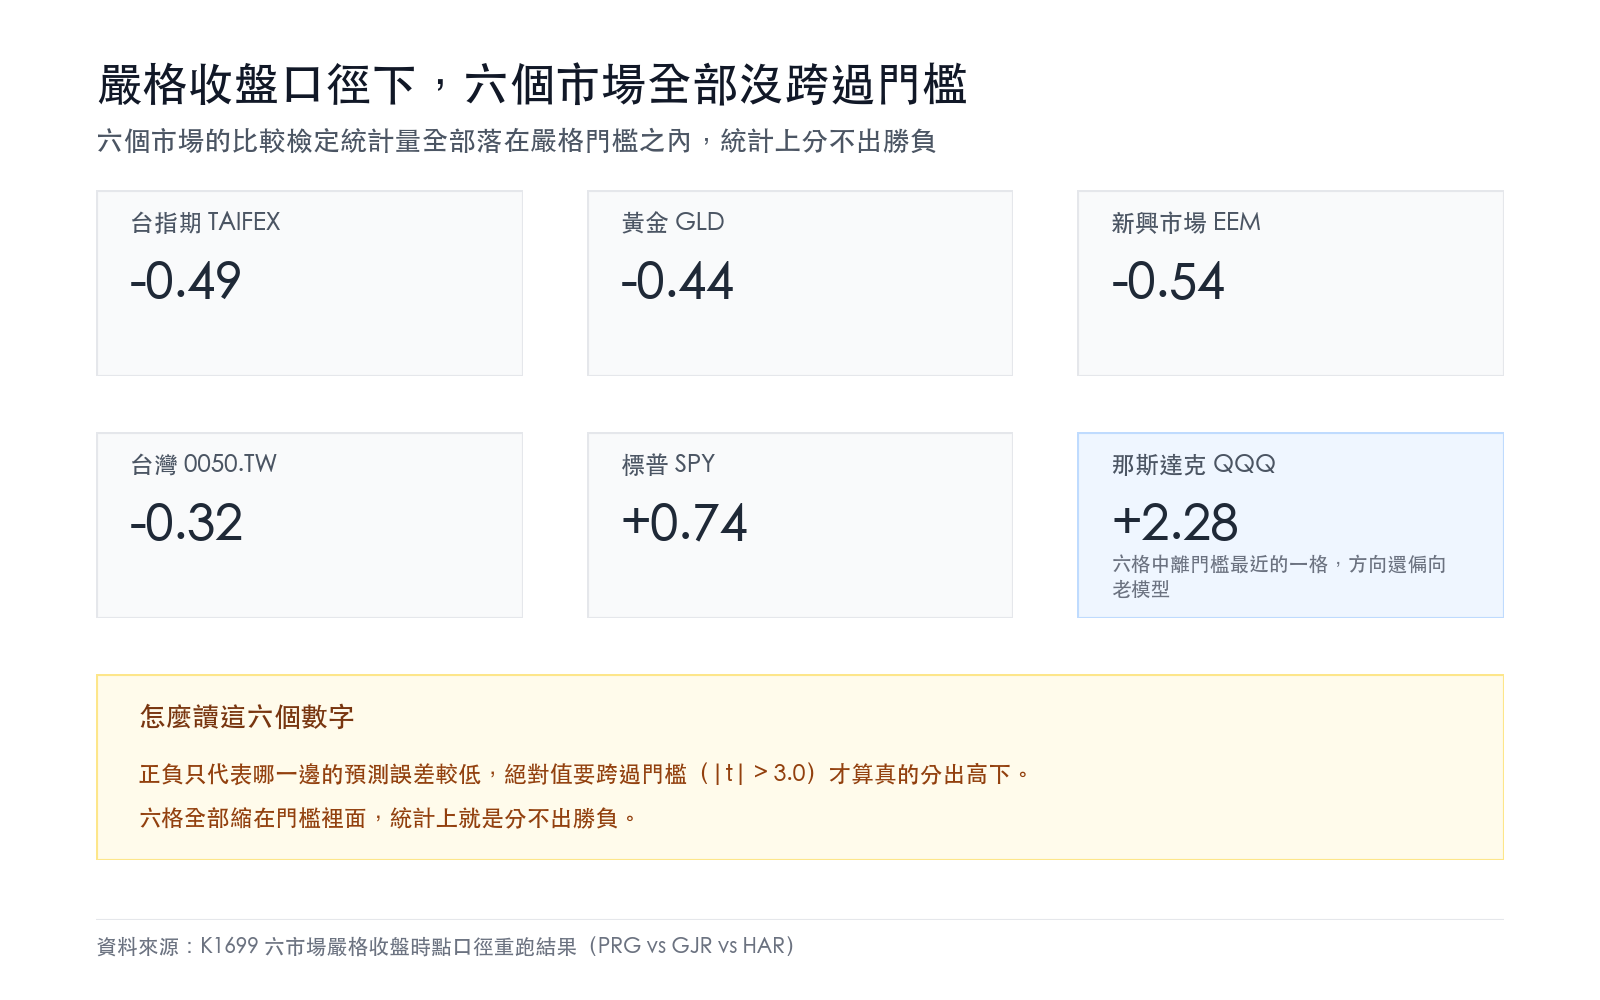
離門檻最近的那根是那斯達克的 +2.28,離 3 還有一段;其餘五個市場連 1 都沒摸到。圖上的正負只代表哪一邊損失較低,不代表誰贏 —— 六根都在門檻內,這張圖的意思就是統計上分不出勝負。
把數字攤開看:
| 市場 | 隔夜佔全日變異數 | DM t(新模型 vs GJR) | 跨過嚴格門檻? |
|---|---|---|---|
| 台指期 TAIFEX | 60.99% | −0.49 | 否 |
| 黃金 GLD | 53.09% | −0.44 | 否 |
| 新興市場 EEM | 52.61% | −0.54 | 否 |
| 台灣 0050 | 46.15% | −0.32 | 否 |
| 標普 SPY | 34.47% | +0.74 | 否 |
| 那斯達克 QQQ | 27.86% | +2.28 | 否 |
負值偏向新模型,正值偏向 GJR,絕對值要超過 3 才算真的分出高下。整張表最極端的一格是 QQQ 的 +2.28,方向還是站在老模型那邊。
樣本不算小。六個市場的樣本外交易日從台指期的 843 天到那斯達克的 1,981 天,合計九千兩百多個交易日,期間橫跨 2020 年的疫情崩盤與 2022 年的空頭,該有的極端行情都在裡面。
最該讓它發光的市場,也沒有發光
這裡是我覺得最硬的一層證據。
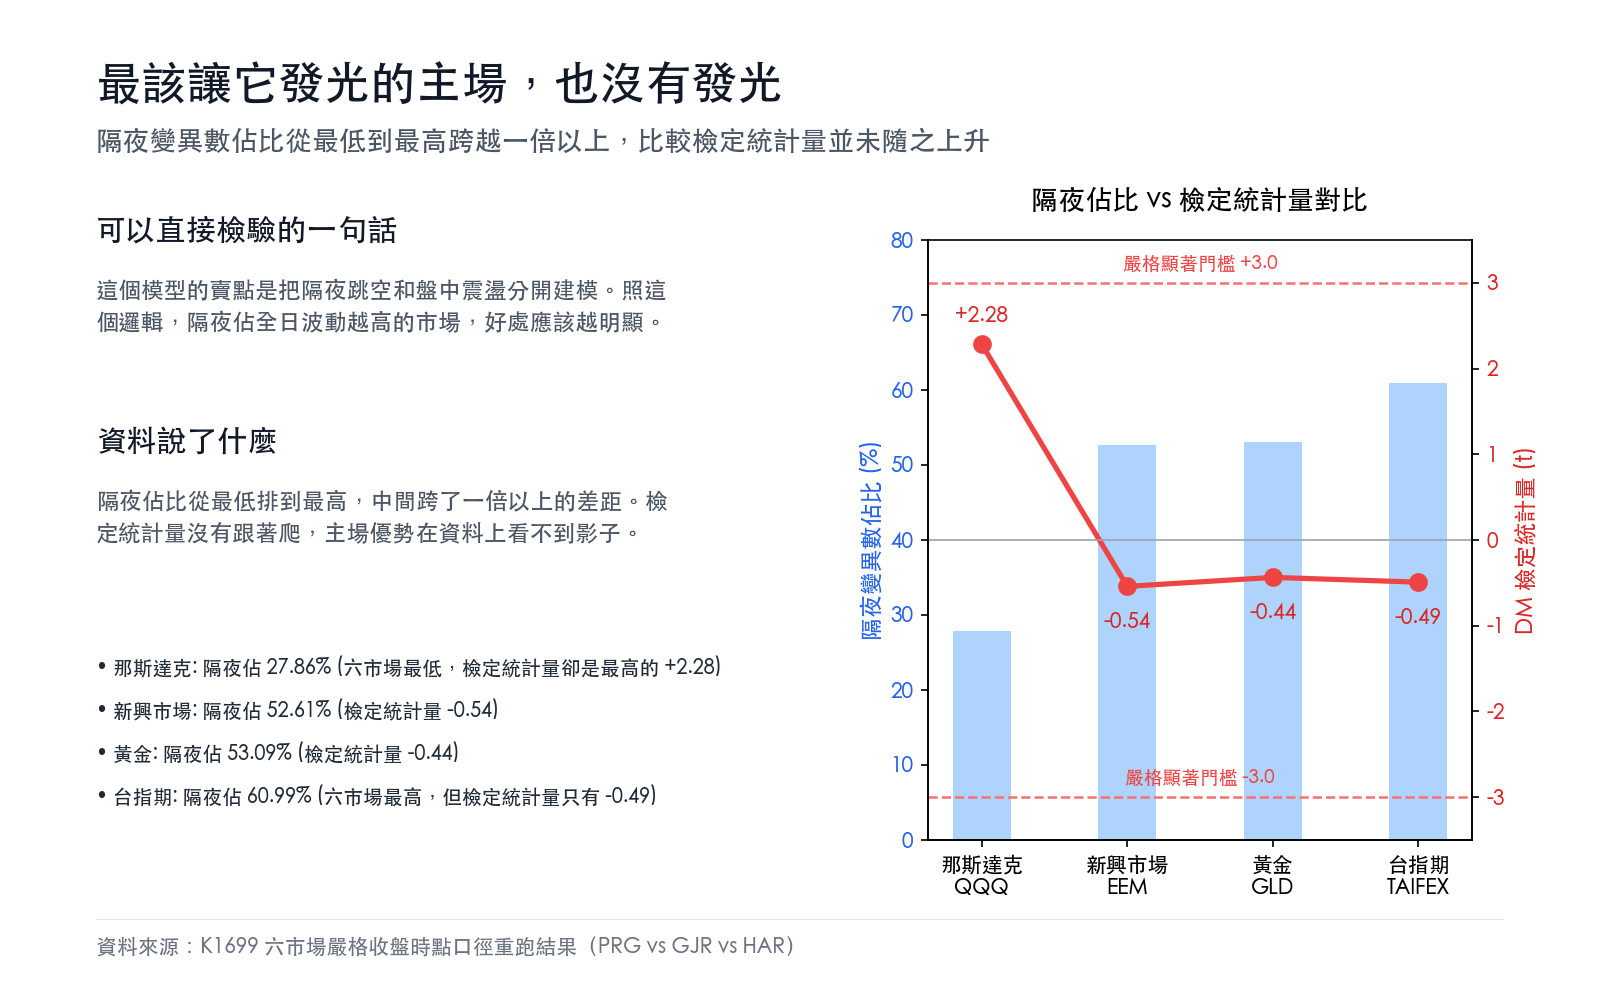
新模型的整套故事建立在「隔夜跳空很重要」上面。照這個邏輯,隔夜佔比越高的市場,拆時段建模的紅利應該越大。這是可以直接拿數字檢驗的預測。
台指期的隔夜佔了全日變異數的 60.99%,超過六成的波動發生在你睡覺的時候。這是六個市場裡的極端值,也是新模型的絕對主場。它拿到的 DM t 是 −0.49。
黃金 53.09%,t = −0.44。新興市場 52.61%,t = −0.54。
把六個市場的隔夜佔比從 27.86% 排到 60.99%,跨越一倍多的差距,DM 統計量卻沒有跟著爬。主場優勢在資料上看不到影子。
檢定本身是有力氣的
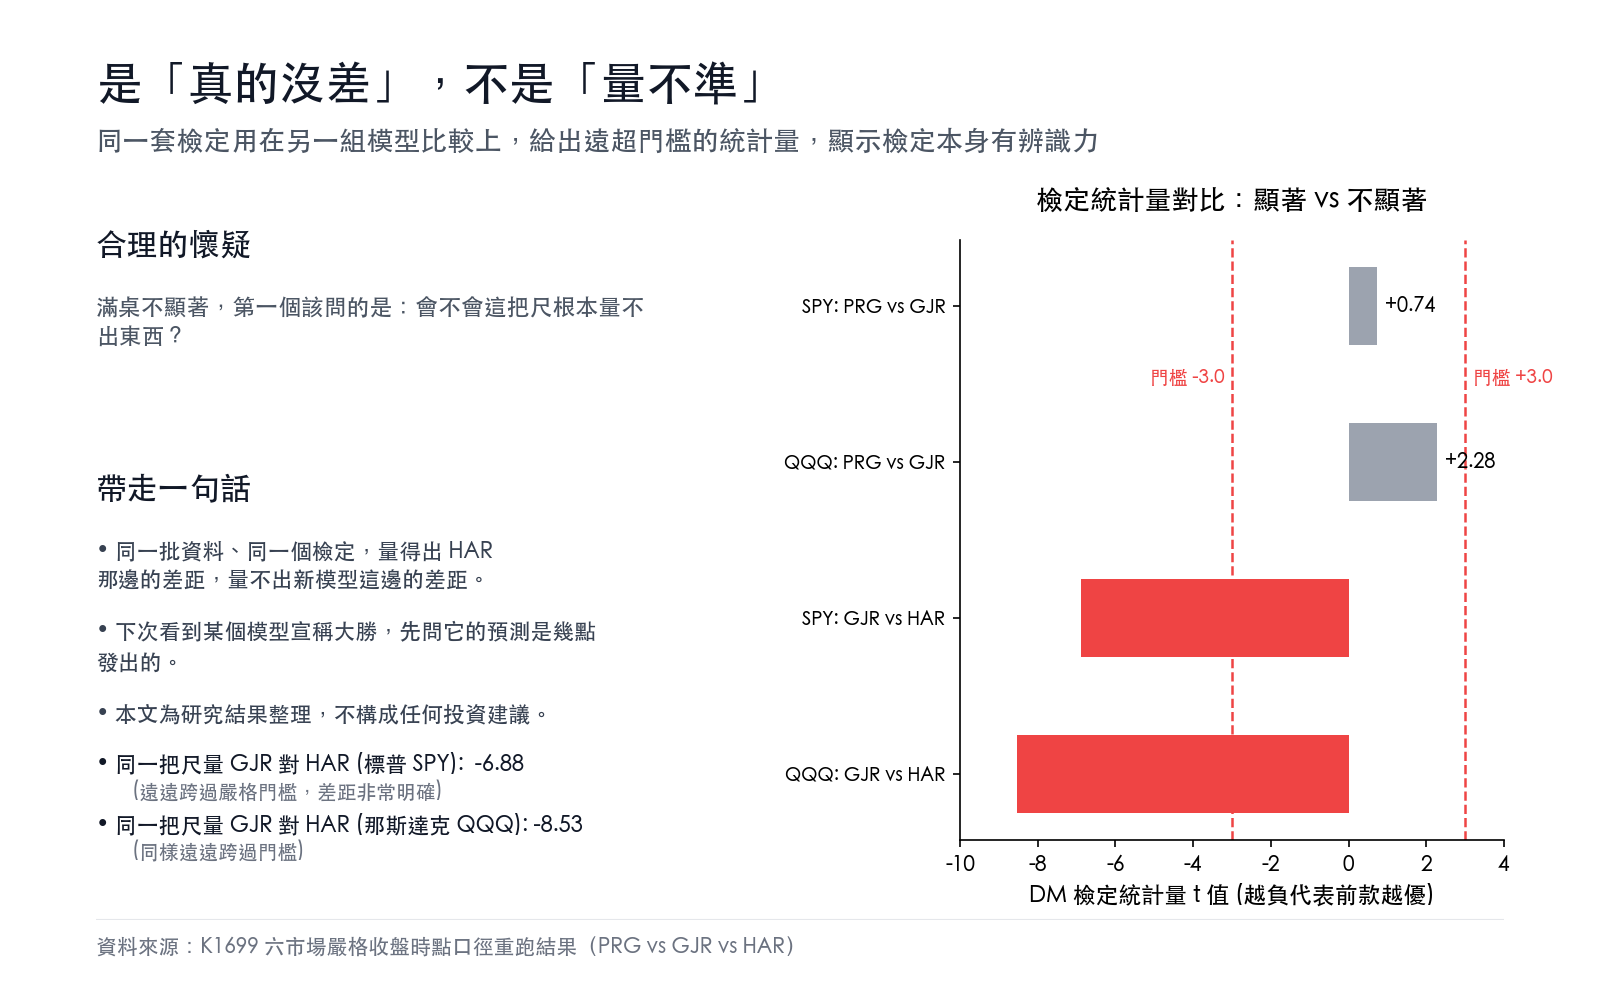
看到滿桌不顯著,合理的懷疑是:會不會樣本太小,這個檢定根本什麼都測不出來?
同一批資料、同一個 DM 檢定、同樣的嚴格門檻,拿去比 GJR 和 HAR,在標普上吐出 −6.88。六個市場裡有五個給出明確的顯著差距。
同一把尺,量得出 HAR 那邊的差距,量不出新模型這邊的差距。所以桌上這排接近零的數字,是「真的沒差」,而非「量不準」。
順帶一提,HAR 在這一題全面落後,並不代表它是壞工具。它只是不適合被拿來預測「全日變異數」這個特定目標。
三件我要老實講的事
第一,這批結果經得起重跑。K1699 的自動複現檢查把 537 個純量逐一比對,537 個全中,零筆不符。文章裡每個數字都能追回 experiments/k1699/k1699_results.json。
第二,比賽場地有一點不平。GJR 和 HAR 每 63 個交易日重新估一次參數,新模型的重估週期是 126 到 252 天。理論上重估越頻繁越占便宜,所以老模型在這裡是稍微被優待的一方。要說死這件事完全不影響結論,我沒有那個底氣,只能說 t 值離門檻的距離遠到不像是靠重估頻率就能補回來。
第三,我只敢主張這張 DM 表的不顯著性。其他看起來像勝負的排名,在這個量級的差距上不夠穩健,我把它們留在實驗檔裡,不寫進正文當賣點。
為什麼一個 null 值得單獨寫一篇
研究線走到這裡,誠實的收尾就是一句「在嚴格的收盤時點口徑下,這個模型沒有贏」。
+5.06 那個數字沒有造假,它只是回答了一個沒人能實際操作的問題。混合時點的口徑允許模型握著一部分未來,於是它表現得像是能預測未來。
模型評比裡最容易被忽略的變數,往往不寫在方法論那一節,而是藏在「你到底幾點按下預測鍵」這種看起來只是流程設定的地方。K1699 的價值就在把那顆按鈕的時間釘死,然後接受它給出的答案。
給要拿這類研究做決策的人一句實用的話:下次看到某個模型宣稱大勝,先問它的預測是幾點發出的,以及那個時點的資訊集合裡有沒有混進當天才知道的東西。這一題問下去,很多漂亮的統計量會安靜下來。至少在這六個市場上,收盤時點要用的模型,一個老實的 GJR 就夠了。
資料來源:yfinance(SPY / QQQ / GLD / EEM / 0050.TW)、TAIFEX 逐筆 tick(台指期)。實驗代號 K1699,程式 experiments/k1699/k1699.py,結果 experiments/k1699/k1699_results.json,複現報告 experiments/k1699/reproduce_report.json(537/537 純量比對相符)。DM 檢定採 Newey-West HAC 修正,顯著門檻為統計強度 3.0,採小樣本修正後的嚴格標準(完整方法學引用見研究版)。圖檔 experiments/k1699/fig_k1699_close_convention.png。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊