波動率預測最準的模型,為什麼算風險卻輸得最慘?
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
波動率預測最準的模型,為什麼算風險卻輸得最慘?
氣象預報高手不一定是地震預警專家。同一個人,同一批數字,但要回答的問題不一樣,結果就可以天差地遠。
這正是 VolPred 最近一組實驗的核心發現:一個在波動率預測競賽中表現很強的模型,拿去算投資組合的每日風險上限,反而全軍覆沒。
這個實驗在做什麼
我們用 SPY(美股大盤)、QQQ(科技股)、EEM(新興市場)三檔 ETF 做測試。
訓練資料用 2023 年之前的歷史,然後切到 2023 年 1 月到 2024 年 12 月,共 502 個交易日的樣本外期間,讓模型在沒看過的數據上接受考驗。
考試題目是: 每天算出明天最壞狀況能跌多少,準不準?
這個問題有個學術名稱叫 VaR(風險值)。三個資產、兩個信心水準(99% 和 95%),每個方法共有 6 組測驗。
判分標準用的是 Trinity 三重檢定,三張考卷同時過才算通過:
- Kupiec 檢定 :跌破預測下限的天數夠不夠接近理論預期?
- Christoffersen 獨立性檢定 :壞日子是否隨機分散,而不是扎堆出現?
- 動態分位數(DQ)檢定 :過去的市場狀況有沒有影響今天的預測誤差?
三關全過才算合格。
六個方法的成績單
| 方法 | Trinity 通過率(滿分 6) | 說明 |
|---|---|---|
| GJR-GARCH(常態分布) | 6/6 | 每場考試全過 |
| GJR-GARCH(偏態 t 分布) | 6/6 | 每場考試全過 |
| 負向半變異數(RS⁻) | 3/6 | 一半通過 |
| Hybrid GARCH + HAR | 2/6 | 大部分落榜 |
| HAR Log-Range | 0/6 | 全部落榜 |
| HAR + 半變異數組合 | 0/6 | 全部落榜 |
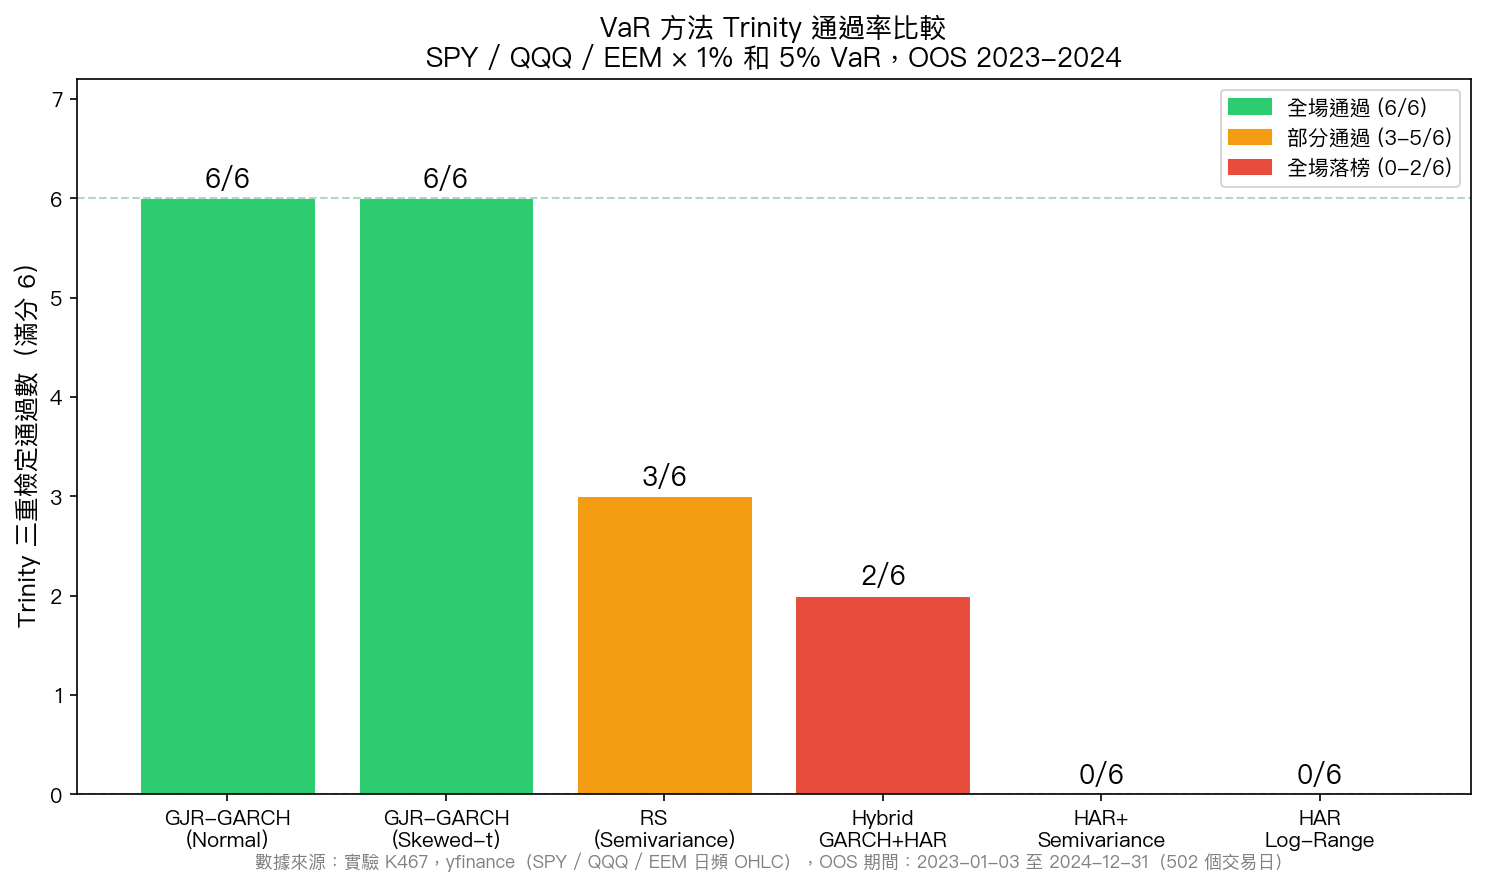
每個「方法」對應 6 個試場:SPY / QQQ / EEM 各 2 個信心水準。
GJR-GARCH 兩個版本滿分通過。HAR 相關的方法,不論是純 HAR Log-Range 還是加了半變異數補強,都是掛零。
HAR Log-Range 在 SPY 的 1% VaR 測試裡,實際跌破次數是 21 次,理論上應只有 5 次。EEM 更慘:跌破 50 次,理論值也只有 5 次。
HAR 到底哪裡出了問題
HAR(Heterogeneous Autoregressive)模型在另一組波動率預測實驗(K465)裡,拿下了 10 場跨資產、跨期間測試的勝利。後續 K469 也特別處理了 K465 的一個方法論疑慮:K465 用 Parkinson range proxy 評估,可能天然偏向 range-based 模型;K469 改用 r² proxy 重新檢查後,HAR 的勝利仍然維持。
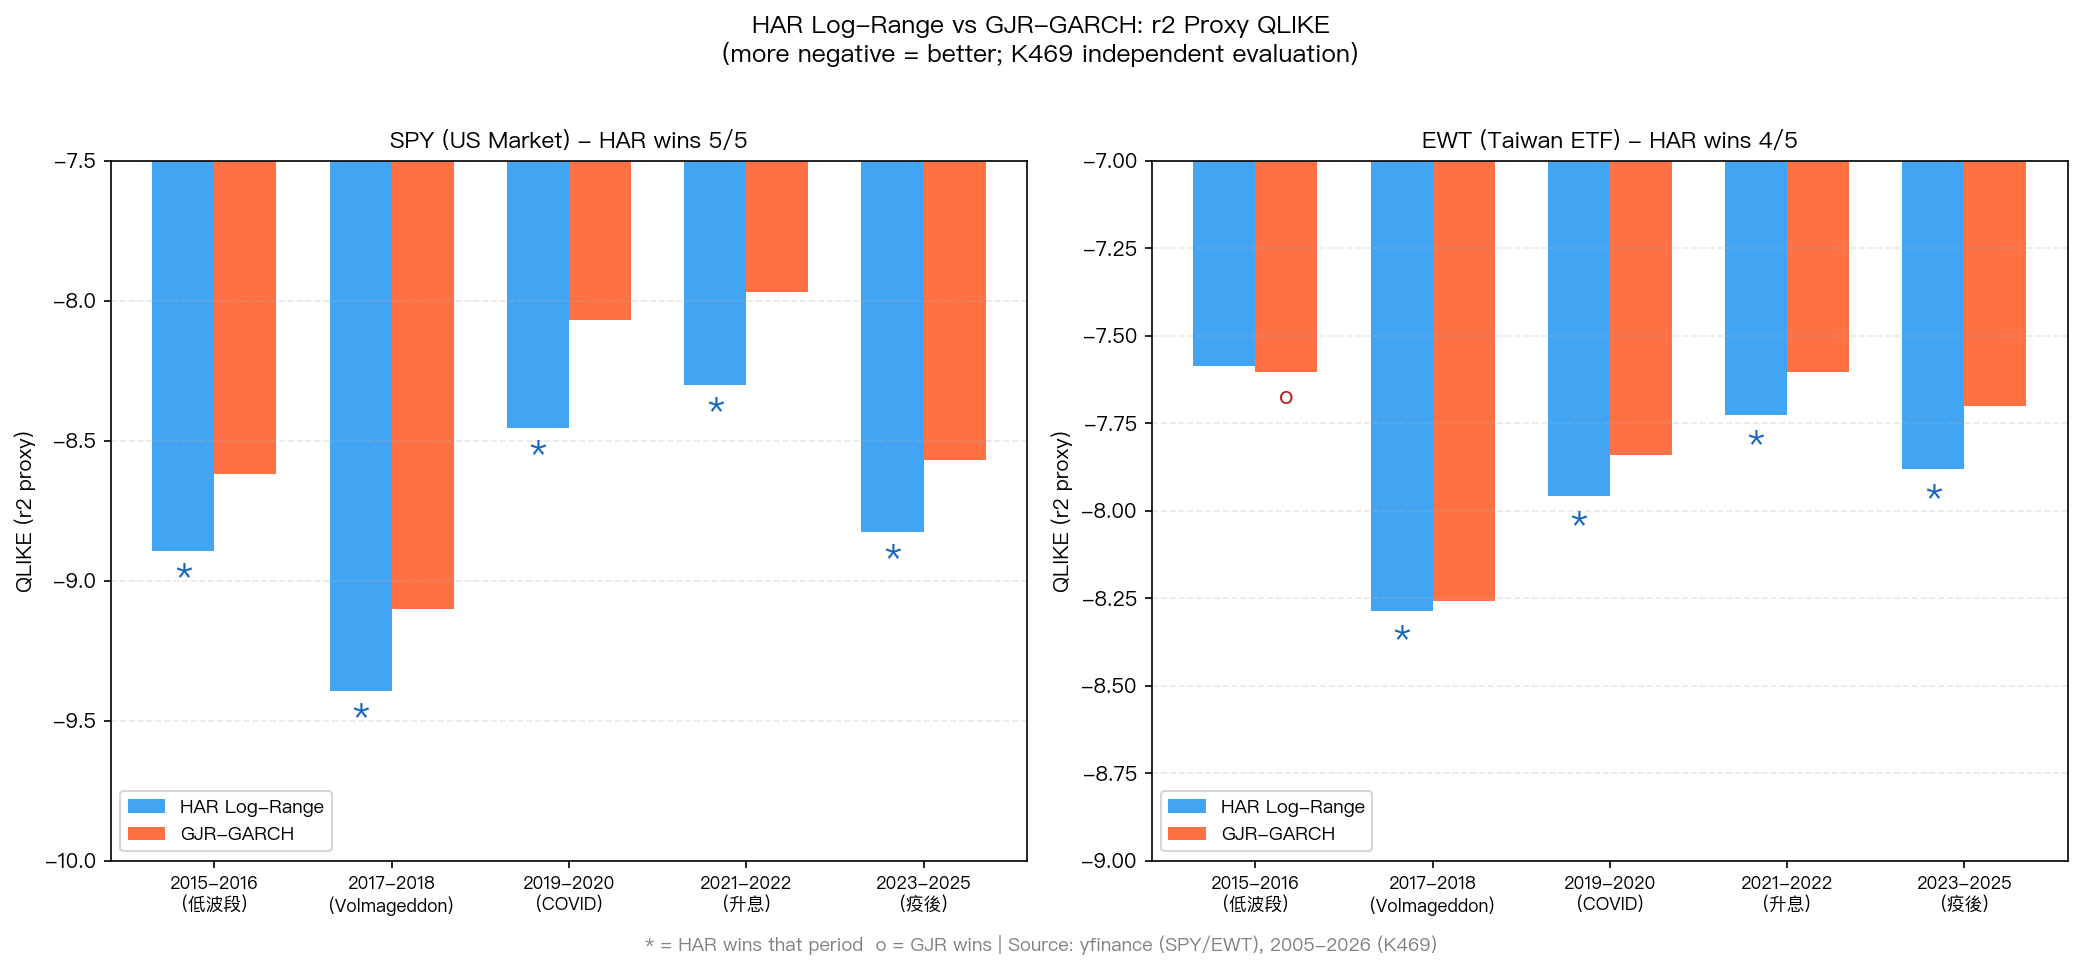
所以這裡的重點不是「HAR 其實不會預測波動率」。重點是: 波動率預測 和 風險預測 是兩件事。
波動率衡量的是整體震盪幅度,上漲或下跌都算。HAR 用的是對數化的每日高低價差,上下都抓進去,平均估得很準。
但 VaR 只關心 下行尾部 。它要問的是:「最壞的 1% 或 5% 的日子,跌幅有多大?」
HAR 對稱地看待好消息和壞消息,好天氣和壞天氣平均後,整體估計準確。問題是,市場跌得特別急的時候,往往是壞消息連續出現、情緒快速惡化的結果,和平均振幅沒有直接關係。
GJR-GARCH 有內建的非對稱機制:跌的時候波動率上升比漲的時候更快,這叫槓桿效應。因此它能更準確地估計「今天跌完,明天的尾部風險有多大」。
加了半變異數(RS⁻)也救不了 HAR,因為 HAR 的整體框架還是基於對稱的波動率,不是以尾部風險為出發點設計的。
這對投資人的意思是什麼
用波動率預測模型去算風險值,有個隱性假設:「預測總波動量準確,就等於知道下行風險在哪」。
這個假設在 HAR 身上被明確否定。
選風險模型之前,值得先問清楚一件事:我要管的是「平均震盪幅度」,還是「最壞狀況下跌多少」?
如果是後者,需要的工具是能處理非對稱、能放大壞消息影響的模型,像 GJR-GARCH 這類設計。
一個模型在 A 任務上得了高分,不代表它適合 B 任務。把 A 的冠軍直接搬過來做 B,有時候輸得比沒打算認真設計的方法還慘。
這也反映在數字上:GJR-GARCH 滿分,Hybrid 混合模型(同時用 GARCH 和 HAR 的資訊)只過了 2/6。混進更多資訊,反而把 GJR-GARCH 原本的尾部判斷能力稀釋掉了。
局限與後續
這組測試局限在三檔美股 ETF 加兩年的樣本外期間(2023-2024)。2023 到 2024 是美股相對穩定的多頭環境,如果換到 2020 年的疫情衝擊或 2022 年升息衝撞,HAR 的問題可能更明顯,也可能在某些方向表現不同。
後續方向包括:對 HAR 加上肥尾分布假設(如 Student-t 或極值分布)、測試 HAR 在債券或商品市場的 VaR 表現、以及更長 OOS 期間的穩健性驗證。
本文基於實驗 K467(腳本:experiments/k467/k467_har_range_var.py,結果:experiments/k467/k467_har_range_var_results.json)、K465 波動率預測驗證實驗,以及 K469 對 K465 proxy tautology 疑慮的 r² proxy 校正。數據來源:yfinance(OHLC 日頻),SPY / QQQ / EEM 期間 2023-01-03 至 2024-12-31,OOS 樣本 502 個交易日。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊