同一個模型、同一批資料,只改它能看到什麼,結論就翻面
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
看到一個模型宣稱打敗基準,最值得問的通常不在「贏多少」。更關鍵的問題是:它在做這個預測的時候,桌上放著哪些資料。
這件事在 SPY 上有一個很乾淨的例子。同一個模型、同一批資料、同一段期間,只把「它能看到什麼」對齊,排名就翻了過去。
這場比較在比什麼
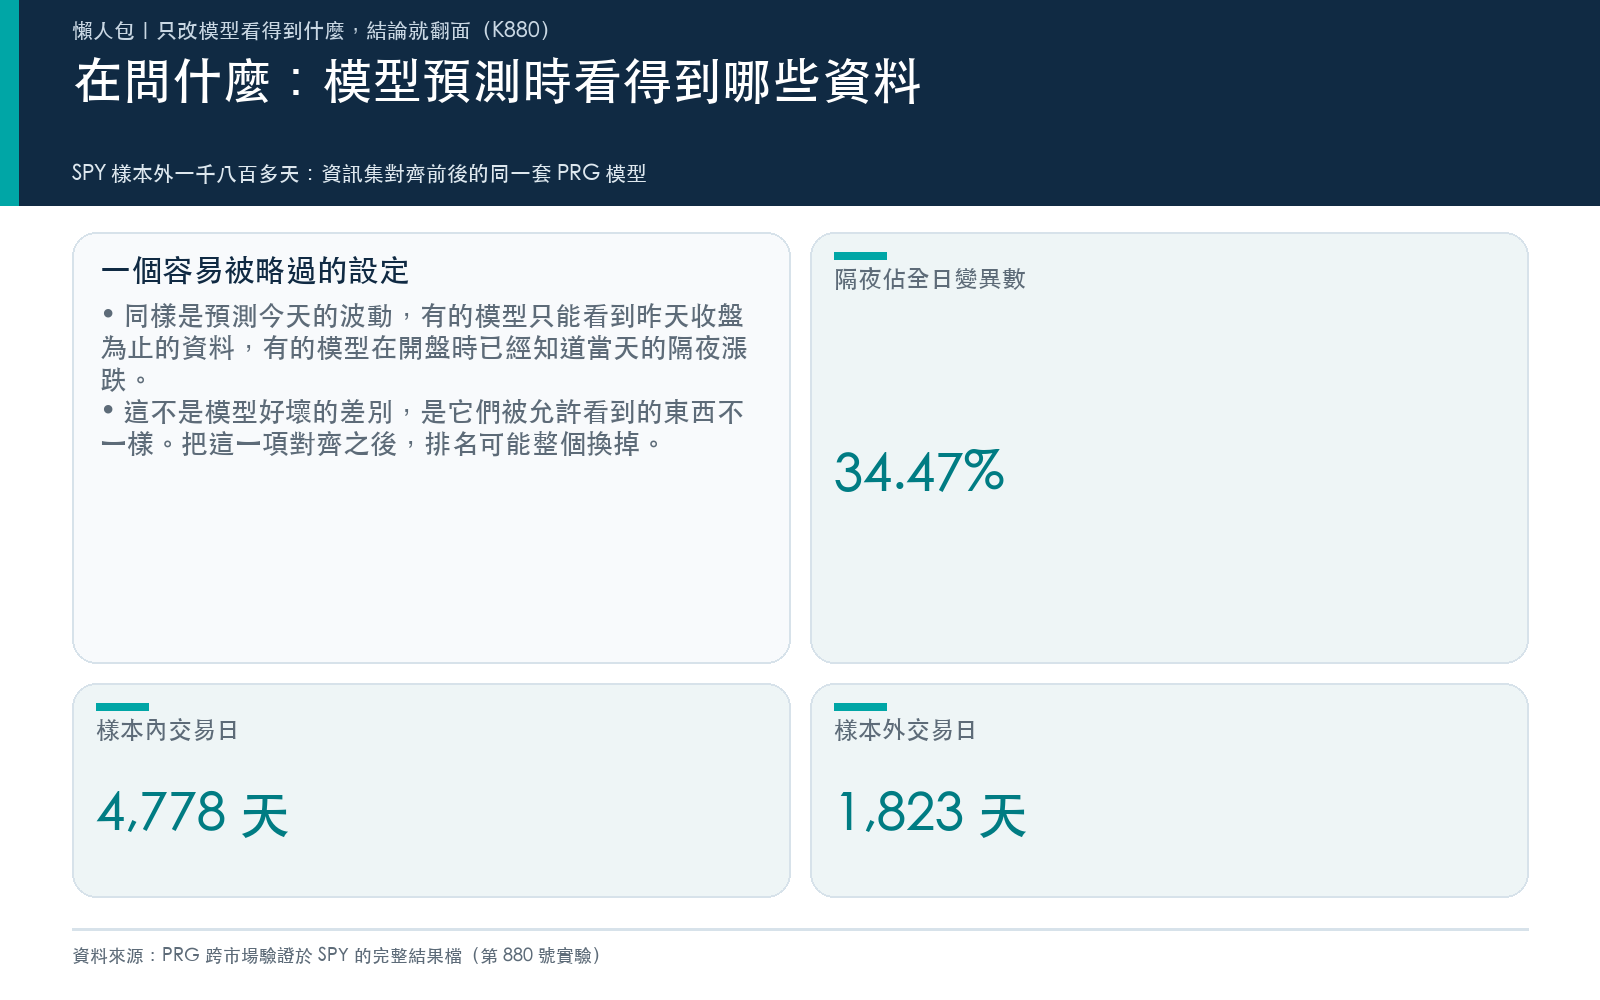
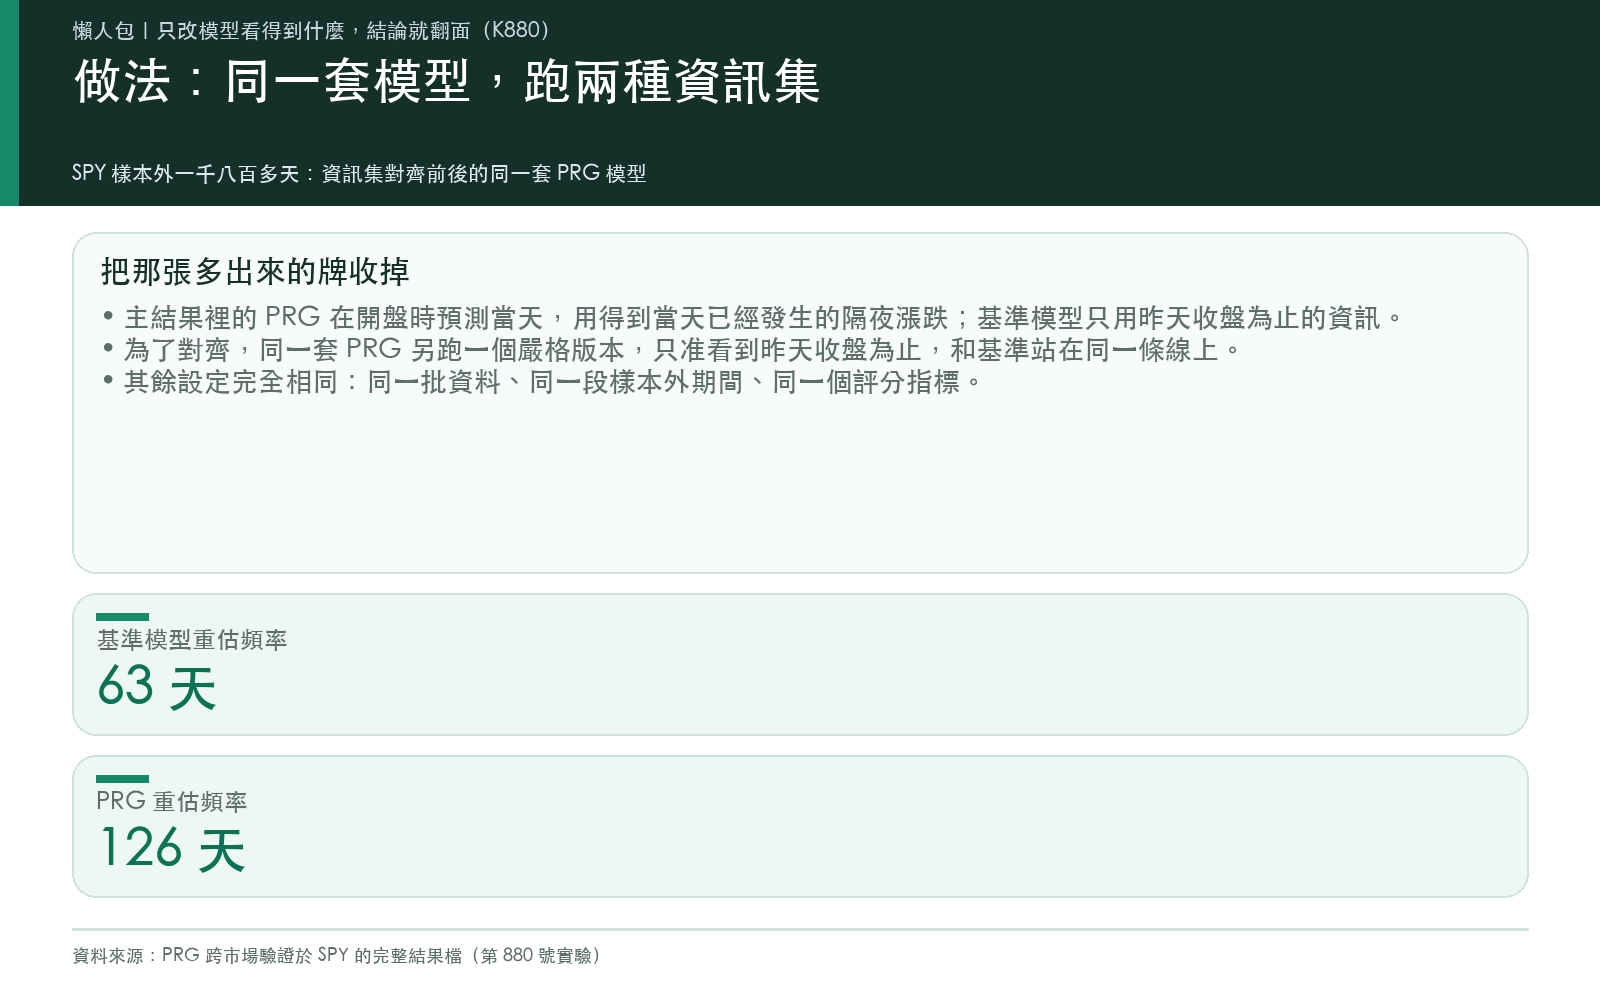
標的是 SPY,也就是追蹤標普 500 的那檔 ETF。樣本內用 4778 個交易日把模型參數估出來,再拿 1823 個交易日做樣本外測試,模型在這段期間內看不到答案。GJR 與 HAR 每 63 天重新估一次參數,PRG 每 126 天一次。
被比較的是六個模型。HAR 用過去已經發生的波動去推未來;GJR 是波動率預測的標準基準,會處理「跌的時候波動比漲的時候大」這件事;Separate 把隔夜和盤中拆開、各自獨立預測;PRG 系列同樣拆成隔夜與盤中兩段,但多做一件事,讓兩段之間的狀態互相傳遞。
拆兩段的理由是 SPY 的波動有三分之一發生在收盤到隔天開盤之間:隔夜這一段佔全日變異數的 34.47%。這不是可以忽略的零頭。
評分用 預測誤差分數,一個專門評波動率預測的誤差指標,數字越小越好。
表面上的結果
| 模型 | 預測誤差分數(越低越好) |
|---|---|
| PRG_Extended | 0.7519 |
| PRG_Basic | 0.7656 |
| GJR | 0.8538 |
| Separate | 0.8666 |
| HAR | 1.4635 |
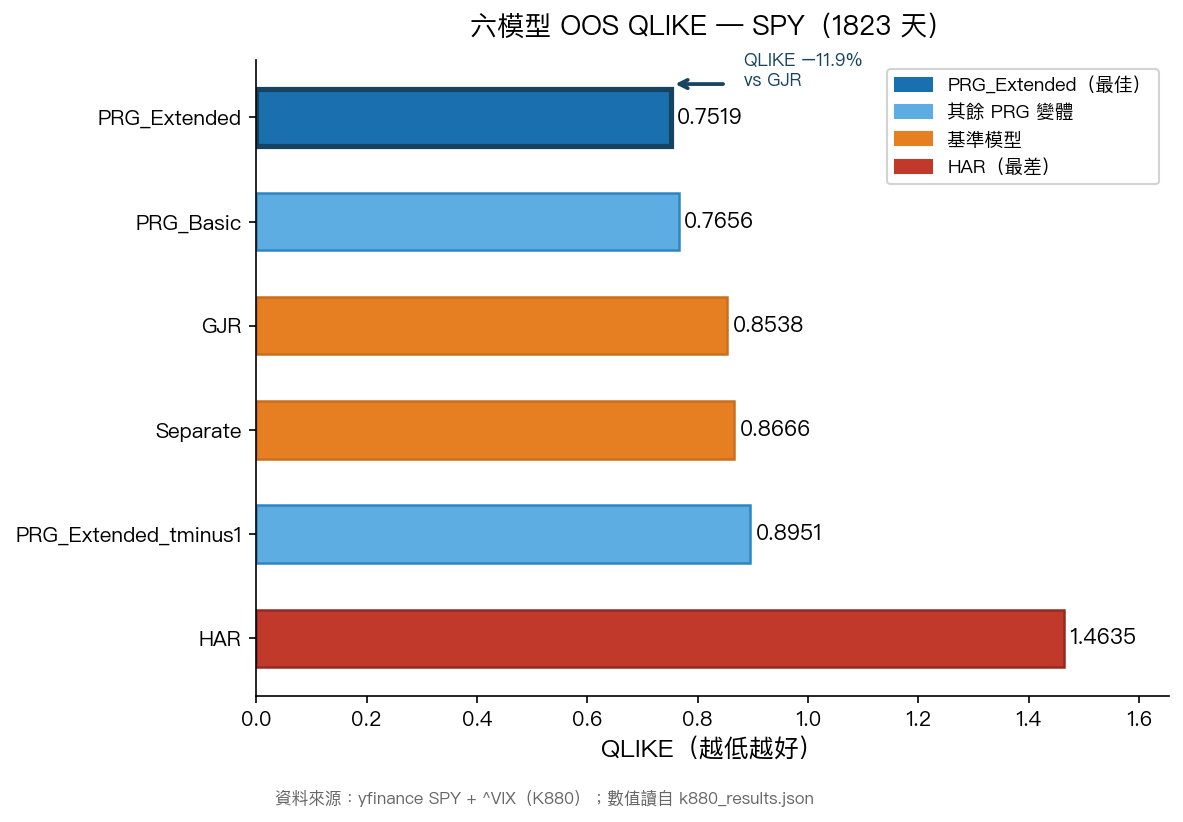
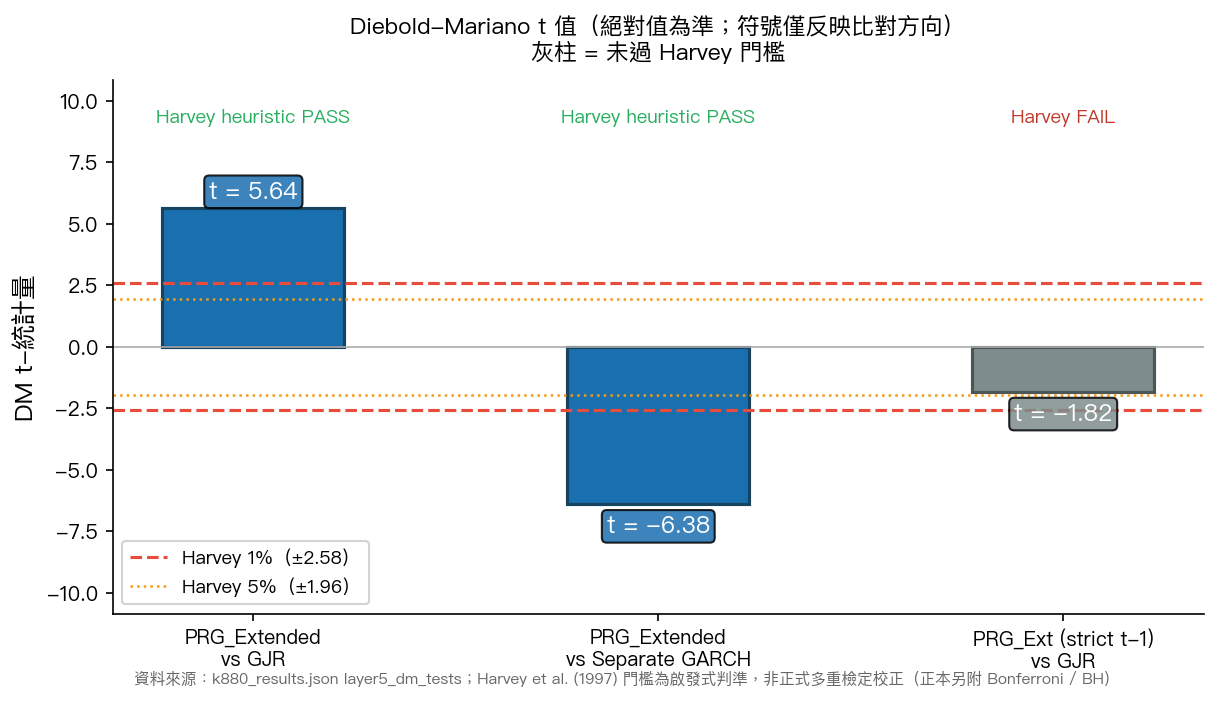
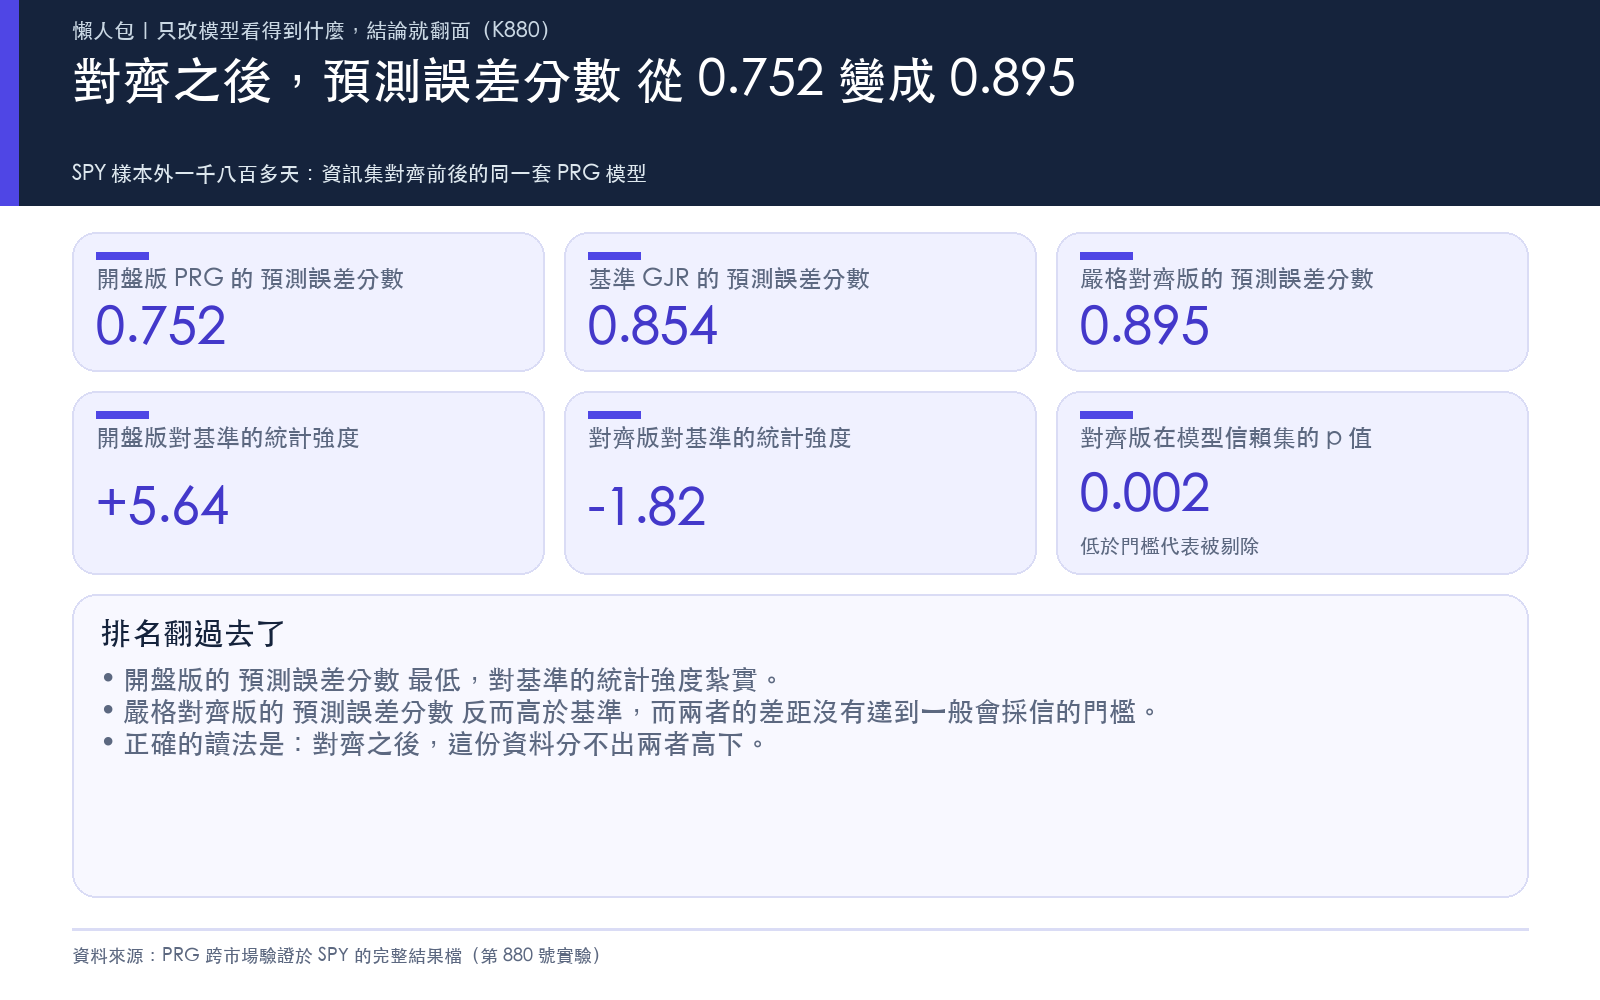
PRG_Extended 拿到最低的 0.7519,比 GJR 的 0.8538 低。兩者的差距做正式比較後,統計強度是 5.64,以這個量級來說是很紮實的差距,不像是運氣。
到這裡為止,故事很順:把隔夜和盤中分開建模、並且讓兩段互通,在美股上也有效。
但這兩個模型看到的東西不一樣
問題藏在時點。
PRG_Extended 做的是「開盤時預測當天」。它在做這個預測的當下,當天的隔夜漲跌已經發生、已經看得到,而它用上了這個資訊。
GJR、HAR、Separate 這三個基準,用的是「昨天收盤為止的資訊」。
也就是說,贏的那一方桌上多了一張牌。這個設定本身不是作弊,它對應一個真實的問題:開盤後要決定當天要承擔多少風險,隔夜跳空確實已經發生、確實可以拿來用。但它回答的不是「昨天收盤後,能不能預測明天」。這兩個問題的答案不必相同。
所以這份實驗多跑了一個版本:同一套 PRG 模型,嚴格只准看到昨天收盤為止的資訊,和基準站在同一條線上。
對齊之後,結論翻面
| 模型 | 預測誤差分數 | 1% 風險值:1823 天裡超限次數 | 超限檢定 |
|---|---|---|---|
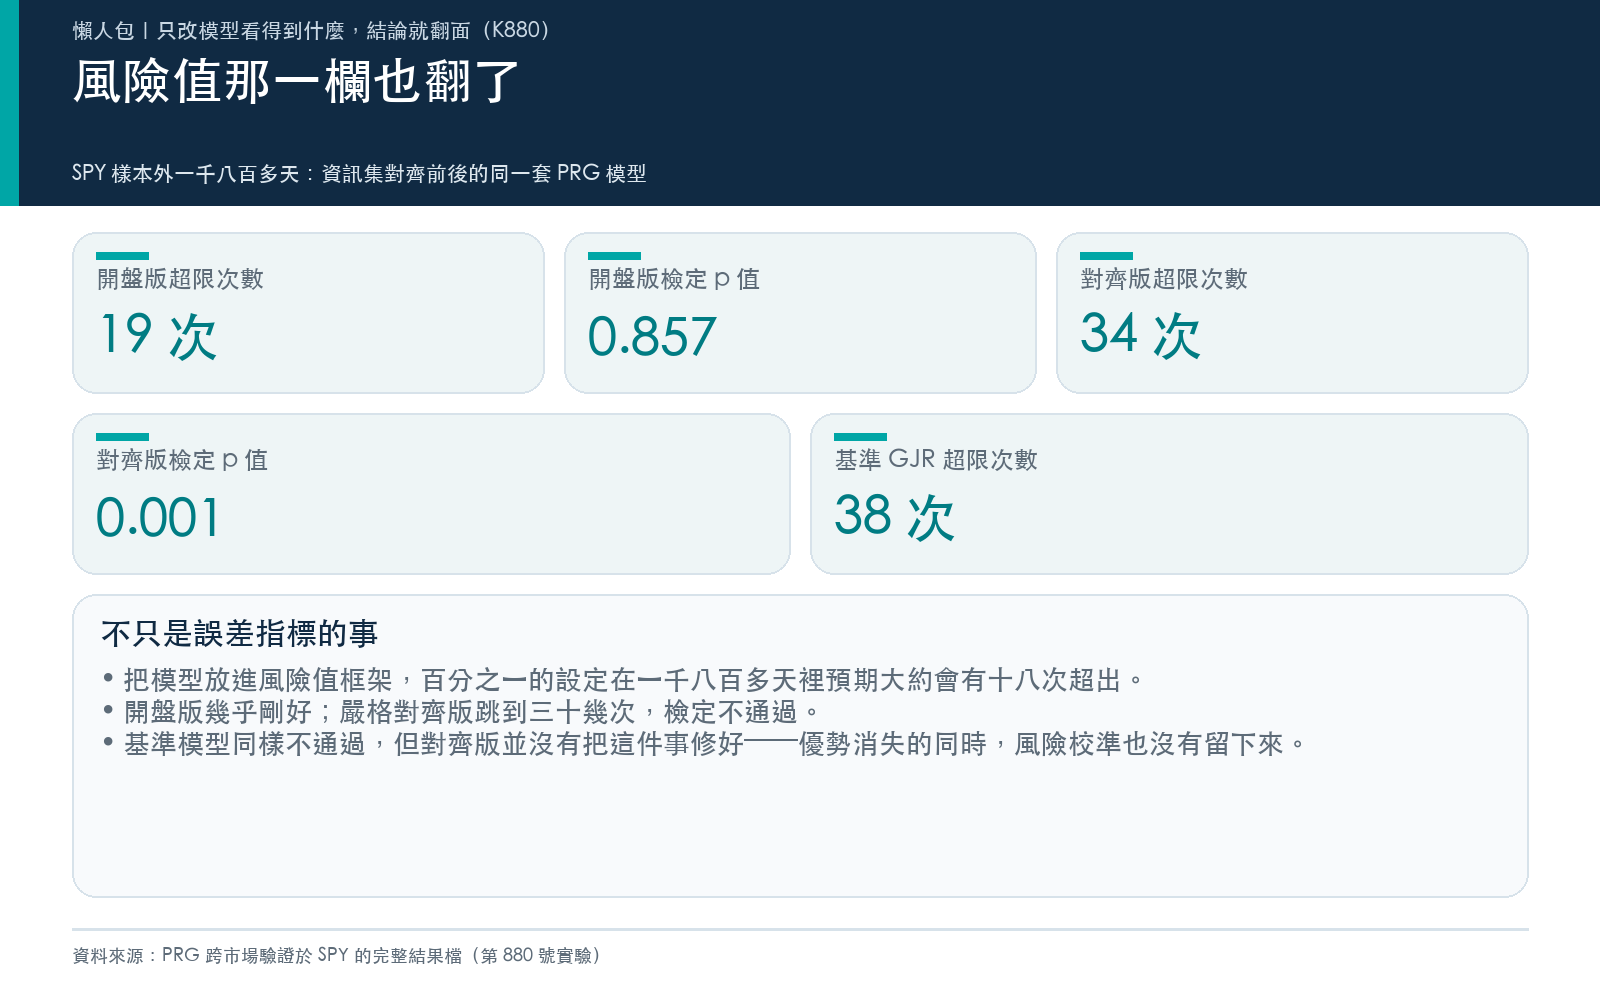
| PRG_Extended(開盤時,看得到當日隔夜) | 0.7519 | 19 | 通過(未達顯著水準(顯著性 0.8571)) |
| GJR(只看到昨天收盤) | 0.8538 | 38 | 不通過(高度顯著(顯著性 0.0000486)) |
| PRG 嚴格對齊版(只看到昨天收盤) | 0.8951 | 34 | 不通過(高度顯著(顯著性 0.0009)) |
把那張多出來的牌收掉,同一個模型的 預測誤差分數 從 0.7519 掉到 0.8951——不只優勢縮小,而是輸給了 GJR 的 0.8538。
差距的統計強度是 -1.82,負號代表方向反過來(GJR 比較好),而這個量級沒有達到一般會採信的門檻,多重比較校正後更是 0.0870。換句話說,對齊之後的正確說法不是「PRG 比較差」,是 這份資料分不出兩者高下 。
模型信賴集也給了一致的答案。這個做法允許「統計上分不出差異的模型」同時存活,在 10% 的標準下,只有兩個 PRG 版本留下來,而嚴格對齊版和 GJR、Separate 一起被剔除,被剔除的那一組 p 值是 0.0018,存活的是 0.1446。
風險值那一欄也翻了。1% 的風險值設定,意思是 1823 天裡預期大約會有十八次超出。開盤時的 PRG_Extended 出現 19 次,幾乎剛好;嚴格對齊版跳到 34 次,檢定不通過。GJR 的 38 次同樣不通過,它低估了尾端風險,但嚴格對齊版並沒有把這件事修好。
排序能力的指標也指向同一個方向:PRG_Extended 的相關係數是 0.5687,嚴格對齊版掉到 0.4632,已經和 GJR 的 0.4752 在同一個水準。
翻面之後,還剩下什麼
有一件事沒有被翻掉,值得單獨講。
Separate 也把隔夜和盤中拆成兩段,差別只在它不讓兩段互通。它的 預測誤差分數 是 0.8666,比不拆的 GJR(0.8538)還差一點。而 PRG_Extended 對 Separate 的統計強度是 -6.38,是一個很清楚的差距。
把兩段拆開卻不連起來,不會變好。真正有貢獻的是「連結」,不是「拆開」。這一點在兩種資訊集下都成立,因為它是 PRG 和 Separate 的比較,兩者的時點設定是同一套。
跨市場的部分也留著。同一套模型在台灣期交所的資料上,PRG_Extended 的 預測誤差分數 是 0.198,GJR 是 0.448,統計強度 5.1。台股和美股的 預測誤差分數 絕對值不在同一個量綱上,不能直接比大小,但兩邊都指向同一個機制:隔夜這一段不能當成零頭,而且要和盤中連起來看。
只是台股那一邊的比較,同樣帶著資訊集的前提,不該被讀成無條件的結論。
這件事可以怎麼用
這篇的重點不是 PRG 或 GJR 哪個好。實際上在對齊之後,這份資料對這個問題的回答是「分不出來」。
重點是那個翻面本身。同一個模型、同一批資料、同一段期間、同一個評分指標,只改了它在預測當下被允許看到什麼,預測誤差分數 從最低變成落後,統計上的優勢消失,風險值檢定從通過變成不通過。
所以下次看到一個預測績效的宣稱,不論是模型、策略還是指標,有一個問題幾乎永遠值得問: 它在做這個預測的時候,有沒有用到那個時點還拿不到的東西。
這個問題便宜,而且它問的不是誠信,是設定。多數時候答案是無辜的,某個欄位在資料表裡就是當天的,回測的時候沒有特別去想。但它對結論的影響可以大到把排名整個翻過來,就像這裡一樣。
資料來源:yfinance SPY,樣本內 2000-01-04 至 2018-12-31,樣本外 2019-01-02 至 2026-04-02。實驗編號 K880,程式碼與結果檔在 experiments/k880/,本文兩張圖由該目錄的 figs/gen_figs.py 從同一份結果檔讀值產生。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊