回測總經風險模型,用今天修正完的數字會不會高估成績?三個市場、近二十年的檢查,沒有偵測到差異
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
做風險模型的人常把總經數據放進模型,再用歷史資料檢查它在過去有沒有用。問題是,工業生產、就業與失業率公布之後常被修正。今天下載的歷史數字,是修正完的版本;模型當年實際看到的,是第一次公布的版本。用修正完的數字回測,成績會不會被偷偷墊高?
這篇用三個市場、近二十年的每日資料檢查這件事。答案是:沒有偵測到。用修正完的數字,並沒有讓模型看起來比用當時數字更好。但這是「沒有偵測到」,不是「修正不重要」。
怎麼比
研究把同一個模型做成兩個版本,只換總經數據:一版用當時公布的數字,一版用現在下載的修正完的數字。其他部分完全相同:同樣的資產、同樣的預測日、同樣的估計方法。預測在前一天收盤後做出,只用當時已經公布的資料。
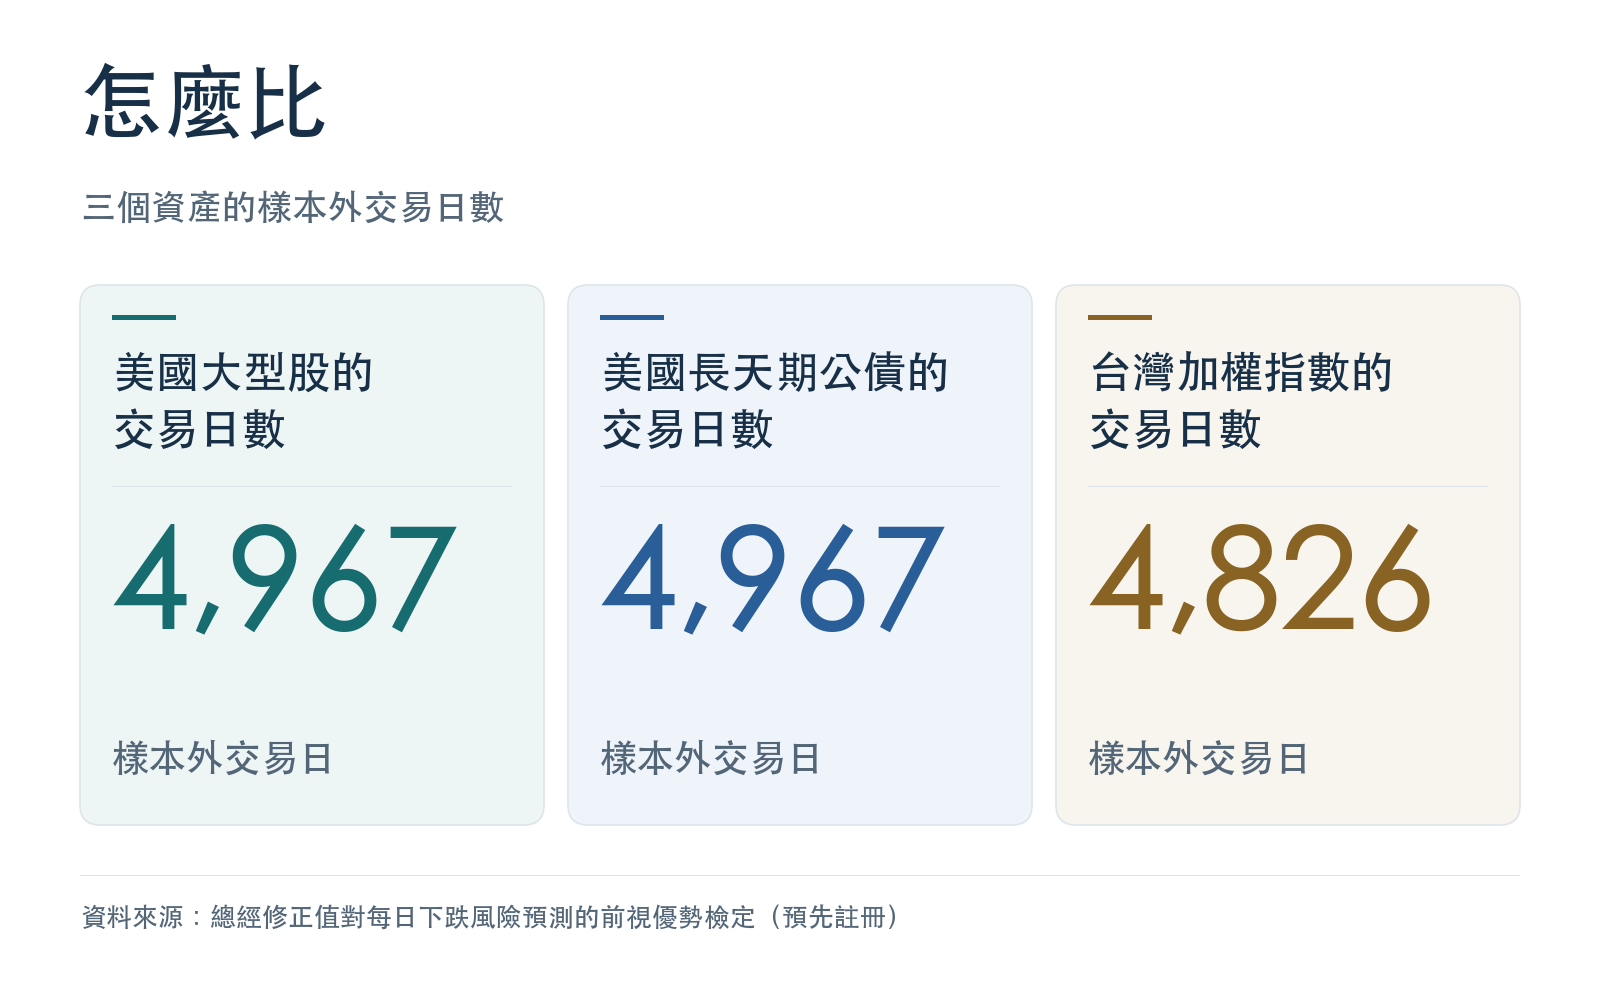
模型預測的是每日的下跌風險:在最壞的 2.5% 日子裡,損失會到多深。研究用一個同時評分「門檻」與「超過門檻後的平均損失」的損失分數,分數越低越好,再逐日比較兩個版本的分數差。三個資產是 SPY(美國大型股 ETF)、TLT(美國長天期公債 ETF)和台灣加權指數,分別有 4,967、4,967、4,826 個樣本外交易日,起點在 2007-01-03 前後。
修正有多大
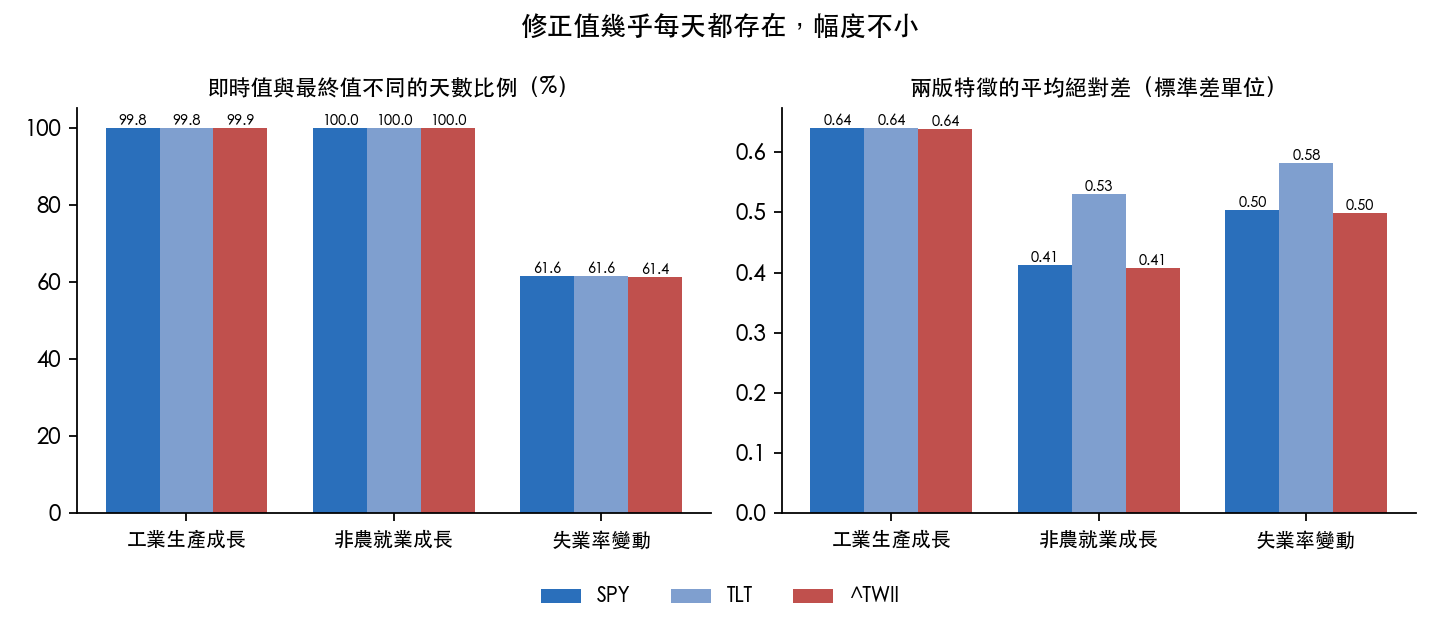
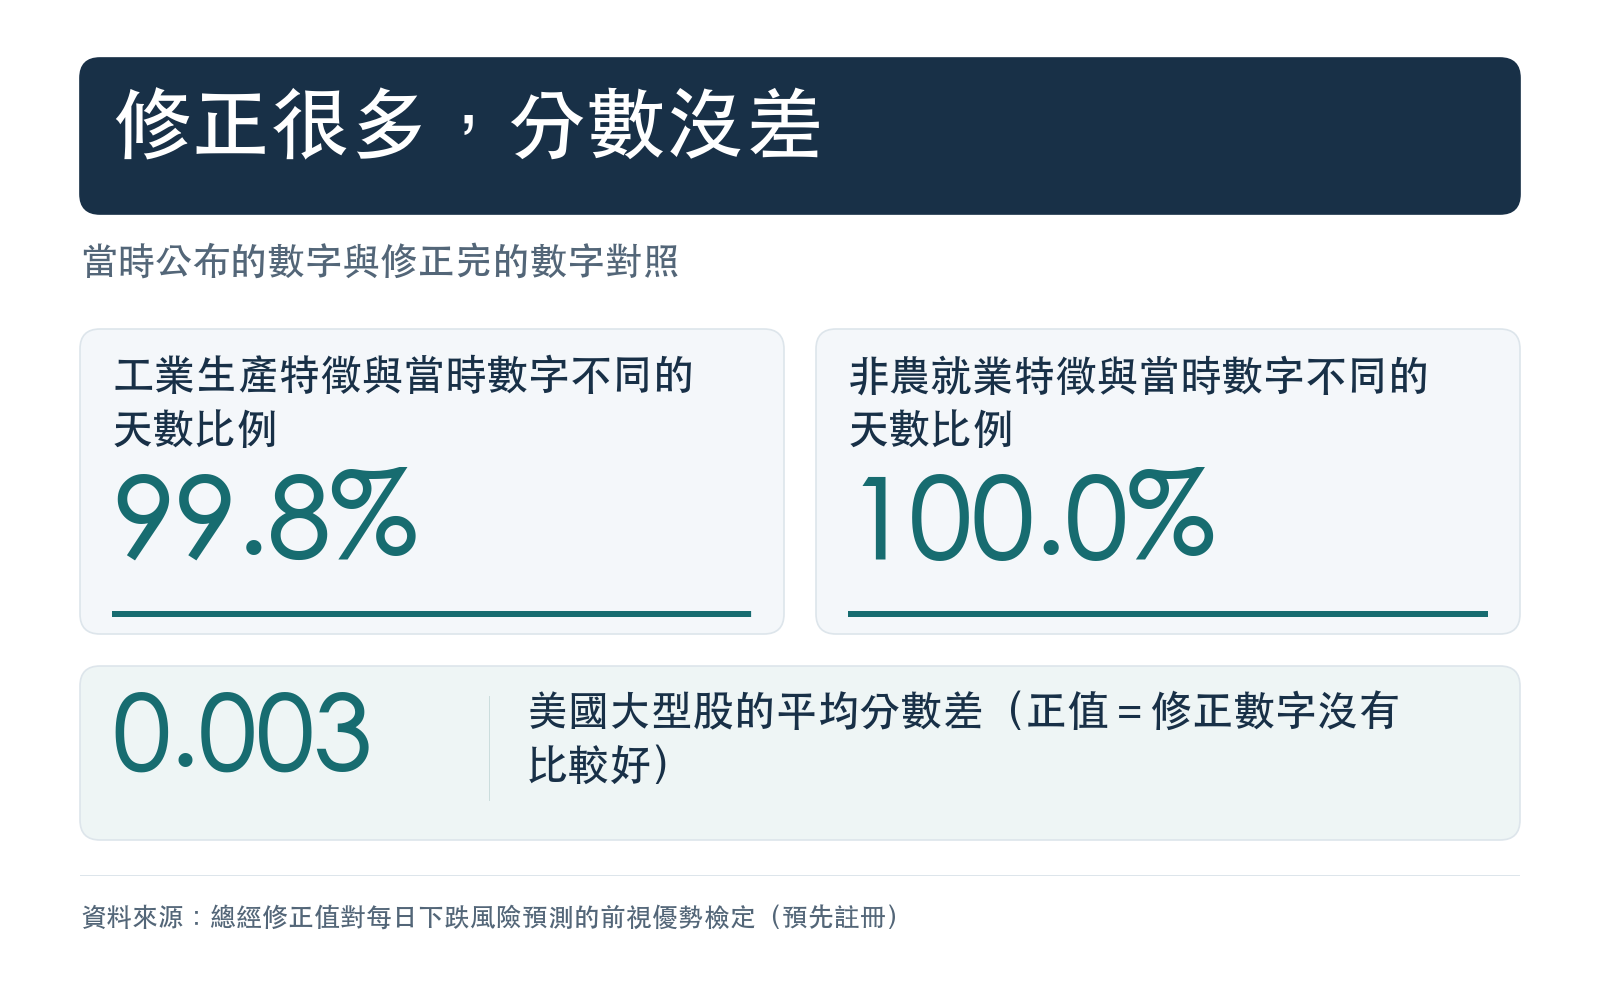
修正並不小。用當時數字與修正完的數字比,工業生產的特徵在 99.8% 的交易日不同,非農就業在 100.0% 的交易日不同,失業率變動在 61.6% 的交易日不同(以 SPY 的樣本為例,其他兩個資產的比例相近)。工業生產特徵的平均差距有 0.64 個標準差。
分數有沒有差
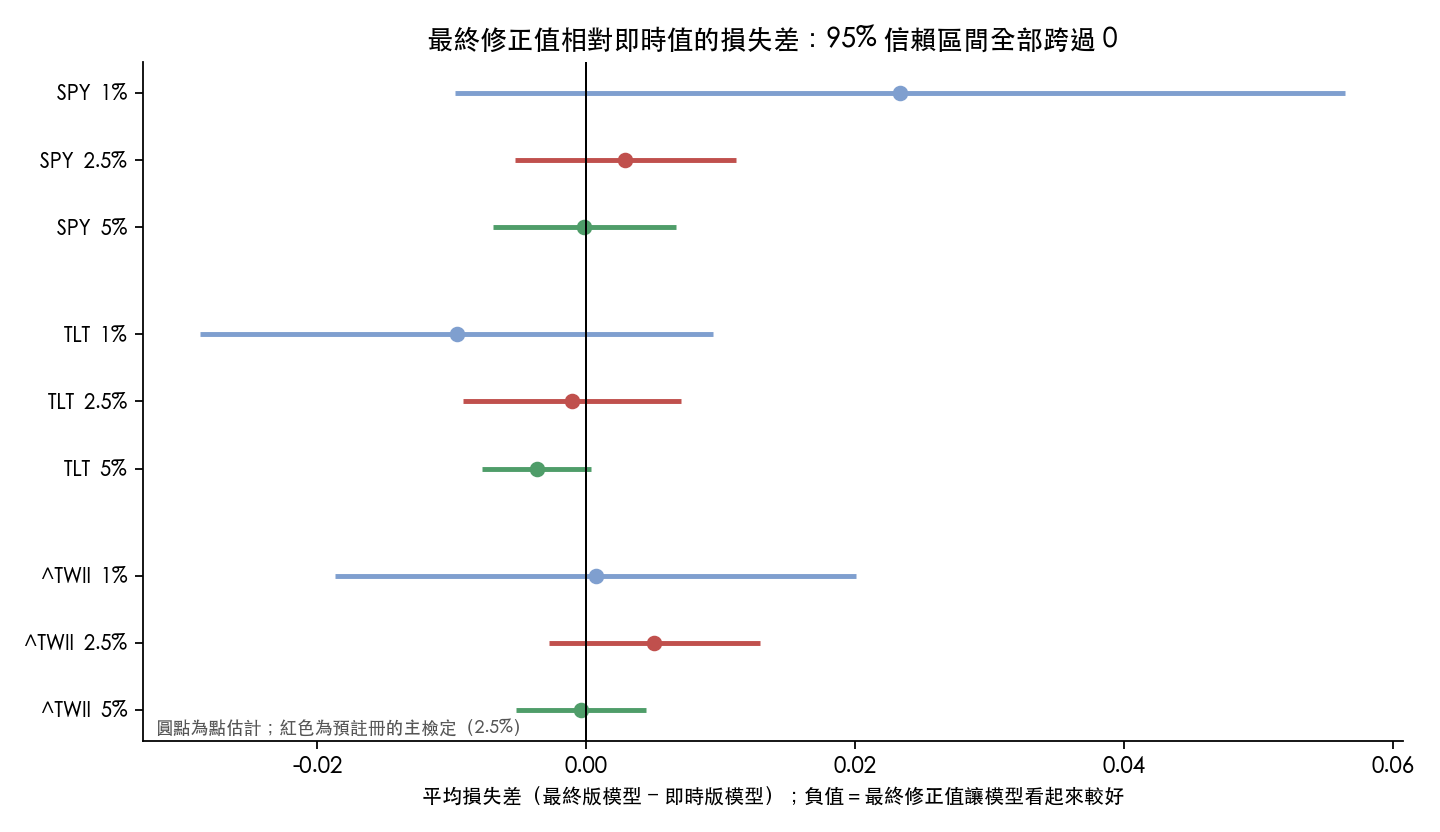
有修正,不代表分數會差。把兩個版本的損失分數相減,用修正完的版本減當時的版本:負值代表修正完的數字讓模型看起來比較好。
| 資產 | 平均分數差 | 95% 可信範圍 |
|---|---|---|
| SPY | 0.00290 | [-0.00530, 0.01110] |
| TLT | -0.00105 | [-0.00914, 0.00703] |
| 台灣加權指數 | 0.00506 | [-0.00279, 0.01291] |
三個資產的信賴區間都包含 0。SPY 與台灣加權指數的平均差是正值,也就是修正完的數字沒有讓模型更好;TLT 的平均差是很小的負值,但同樣不顯著。經過多重比較校正之後,三個資產都沒有一個達到顯著。
這代表什麼
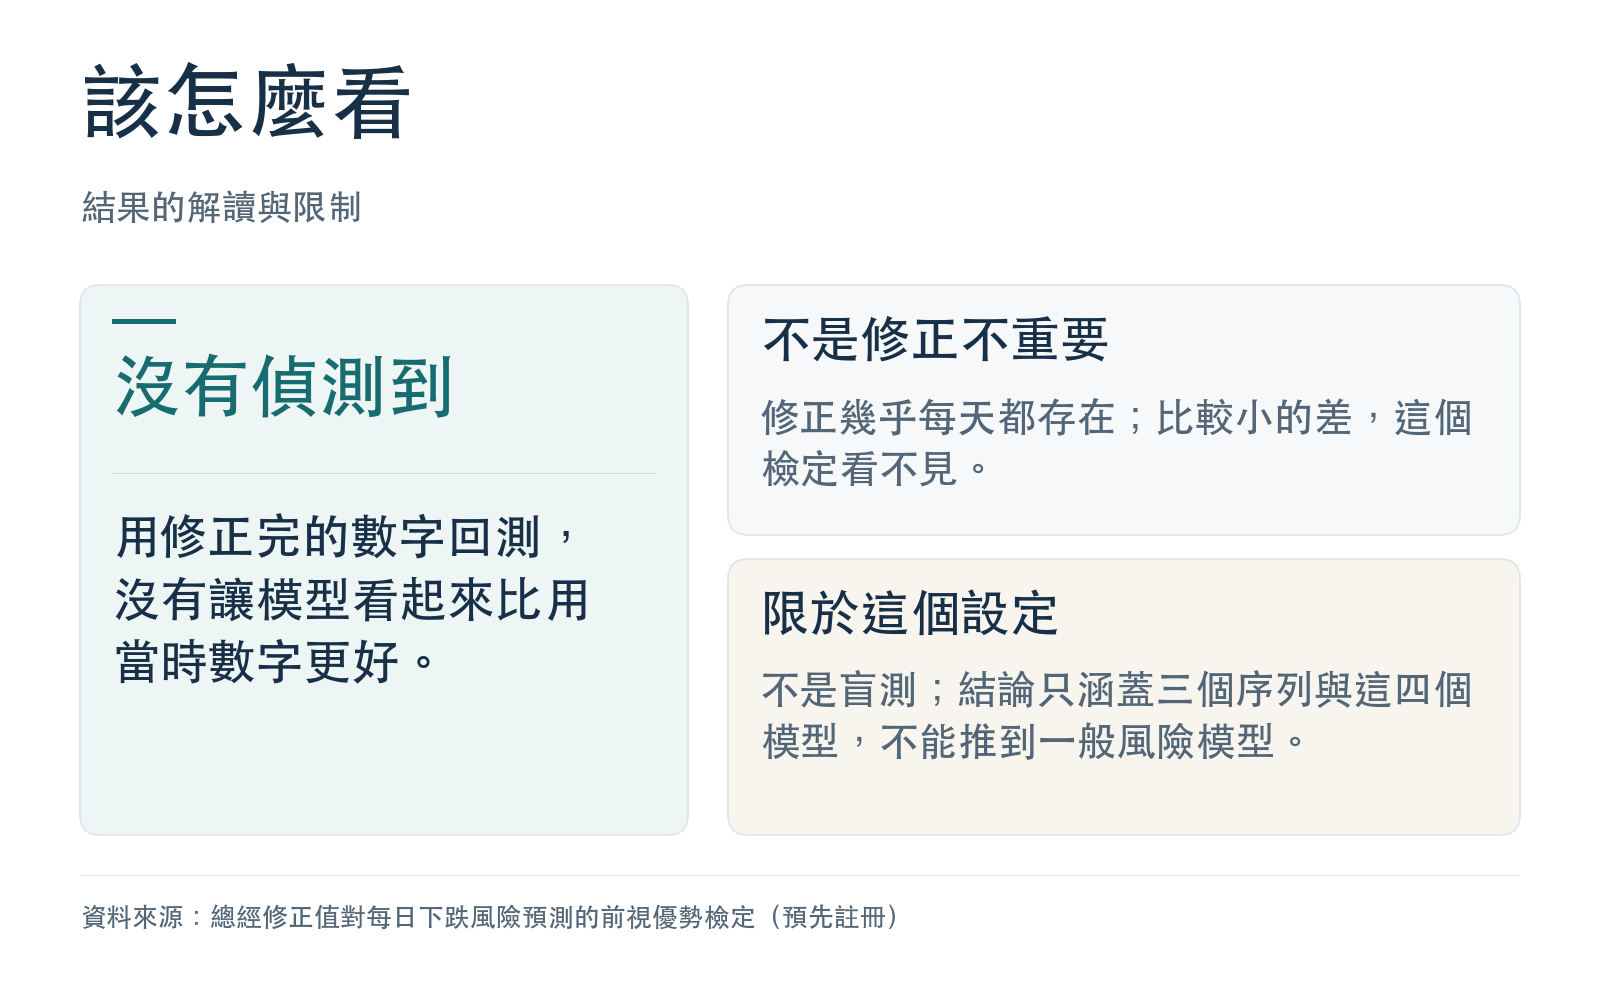
- 能說:在這個樣本與這個模型下,用修正完的數字回測,沒有偵測到前視優勢。
- 不能說:修正不重要。信賴區間有寬度;以 SPY 為例,修正完的數字若讓分數好過 0.00530 以上,資料已經排除這個可能;比這小的差,這個檢定看不見。
- 另一個觀察:總經特徵本身也沒有改善沒有總經數據的基準模型。把總經特徵加進去之後,九個比較格中有八個的點估計損失較高;加入當時數字的模型,在 TLT 的 1% 風險水準,比沒有總經數據的基準顯著變差(校正之後仍然顯著)。這個模型裡本來就沒有多出來的好處,修正值也就沒有東西可以放大。
- 不能外推:結論只涵蓋這三個序列、三個總經指標和這四個模型,不能推到一般的風險模型。
限制
- 不是盲測 :作者事前就預期不會看到差異(預註冊已記載),凍結前也看過部分資料的結構與一個相關實驗的結果。
- 台灣加權指數的價格 來自 yfinance,調整價與收盤價在部分日期不同。
- 2020 年 的特徵標準化後數值極大,槓桿很大;排除 2020 年預測日後,結論不變。
- 「當時」的定義 取決於一個資訊集假設:美國資產只用前一天已公布的版本,台股再早一個日曆日。
- 診斷計數 來自結果檔,獨立重建只涵蓋抽樣的重估區塊;正式執行為一次的說法,無法從版本紀錄獨立證明。
資料來源:ALFRED(工業生產、非農就業、失業率的當時版本與修正版本)與 Yahoo Finance(SPY、TLT、台灣加權指數日價格),樣本外 2007 年起至 2026-09-30。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊