換六把尺量同一件事,第一名六次都是同一個模型
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
換六把尺量同一件事,第一名六次都是同一個模型
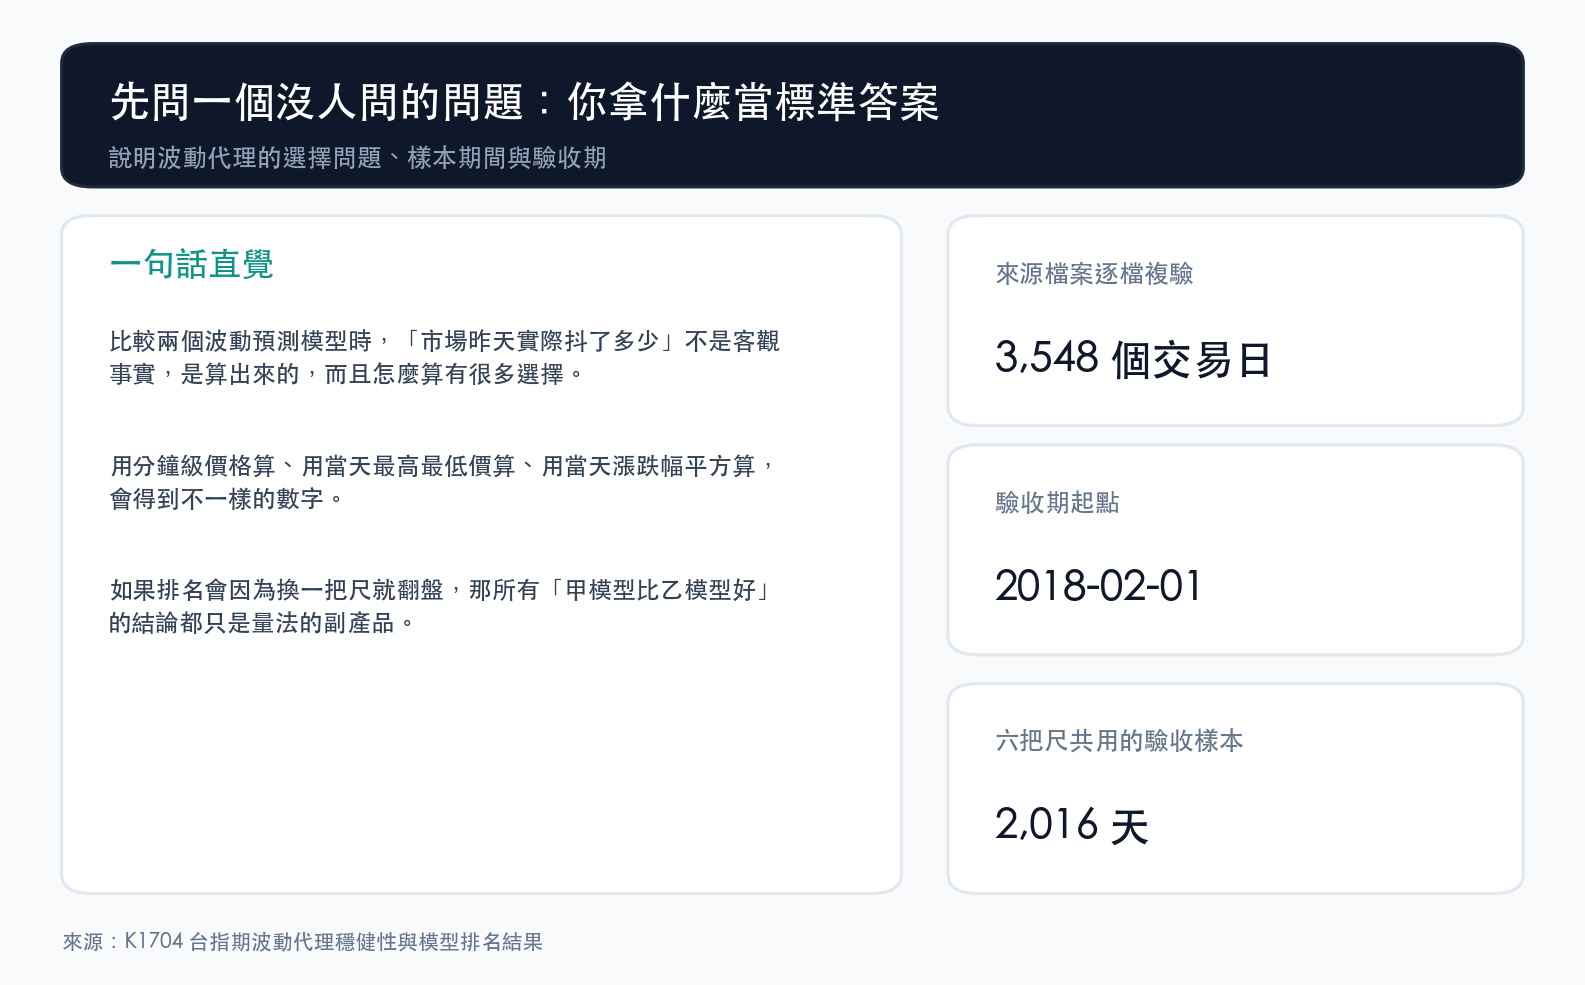
比較兩個波動預測模型,有一件事比模型本身更麻煩:你拿什麼當標準答案。
「昨天市場實際抖了多少」聽起來是個客觀事實,其實不是。它是算出來的,而且怎麼算有很多選擇。用五分鐘一筆的價格去算,跟用當天最高價最低價去算,跟直接用當天漲跌幅的平方去算,會得到三個不一樣的數字。
模型排名如果會因為換一把尺就翻盤,那所有「A 模型比 B 模型好」的結論都只是量法的副產品。
這份研究就是去撞這件事。
六把尺,三個模型
標的是台指期日盤,時間 08:45 到 13:45,不含夜盤、不跨盤別。樣本從 2012 年 1 月 2 日到 2026 年 7 月 14 日,3,548 個交易日。
資料來源是本地的逐筆檔案。這次做了一件平常不會特別講的事:3,548 個來源檔案逐檔比對大小與內容雜湊,3,548 個全部相符。之所以要講,是因為這類研究最容易出事的地方不是模型,是有人在中途換掉了輸入檔而沒人發現。
六把尺:
- 一分鐘一筆算出來的已實現波動
- 五分鐘一筆
- 十分鐘一筆
- 用當日最高最低價算的振幅估計
- 當日漲跌幅的平方
- 把前五把尺按可靠度加權合成的共識值(權重只用過去資料算,不看未來)
三個模型:多尺度模型(把過去一天、一週、一個月的已實現波動疊起來)、指數加權法(愈近的資料權重愈大)、傳統的不對稱波動模型(下跌對未來波動的影響比上漲大)。
驗收期是 2018 年 2 月 1 日到 2026 年 7 月 14 日,2,016 個交易日。六把尺共用同一份日期帳本,所以六次比較的樣本完全一樣,不會出現「這把尺剛好少算了幾個大跌日」這種問題。
六次比較,六次同一個順序
用一種對「低估波動」罰得比「高估」重的損失分數比較,數字越小越好。
| 用哪把尺當標準答案 | 多尺度模型 | 指數加權 | 不對稱模型 |
|---|---|---|---|
| 一分鐘 | 0.1335 | 0.1897 | 0.2031 |
| 五分鐘 | 0.1814 | 0.2326 | 0.2522 |
| 十分鐘 | 0.2298 | 0.2847 | 0.3078 |
| 高低價振幅 | 0.4271 | 0.4976 | 0.5230 |
| 當日漲跌幅平方 | 2.8573 | 3.2192 | 3.2784 |
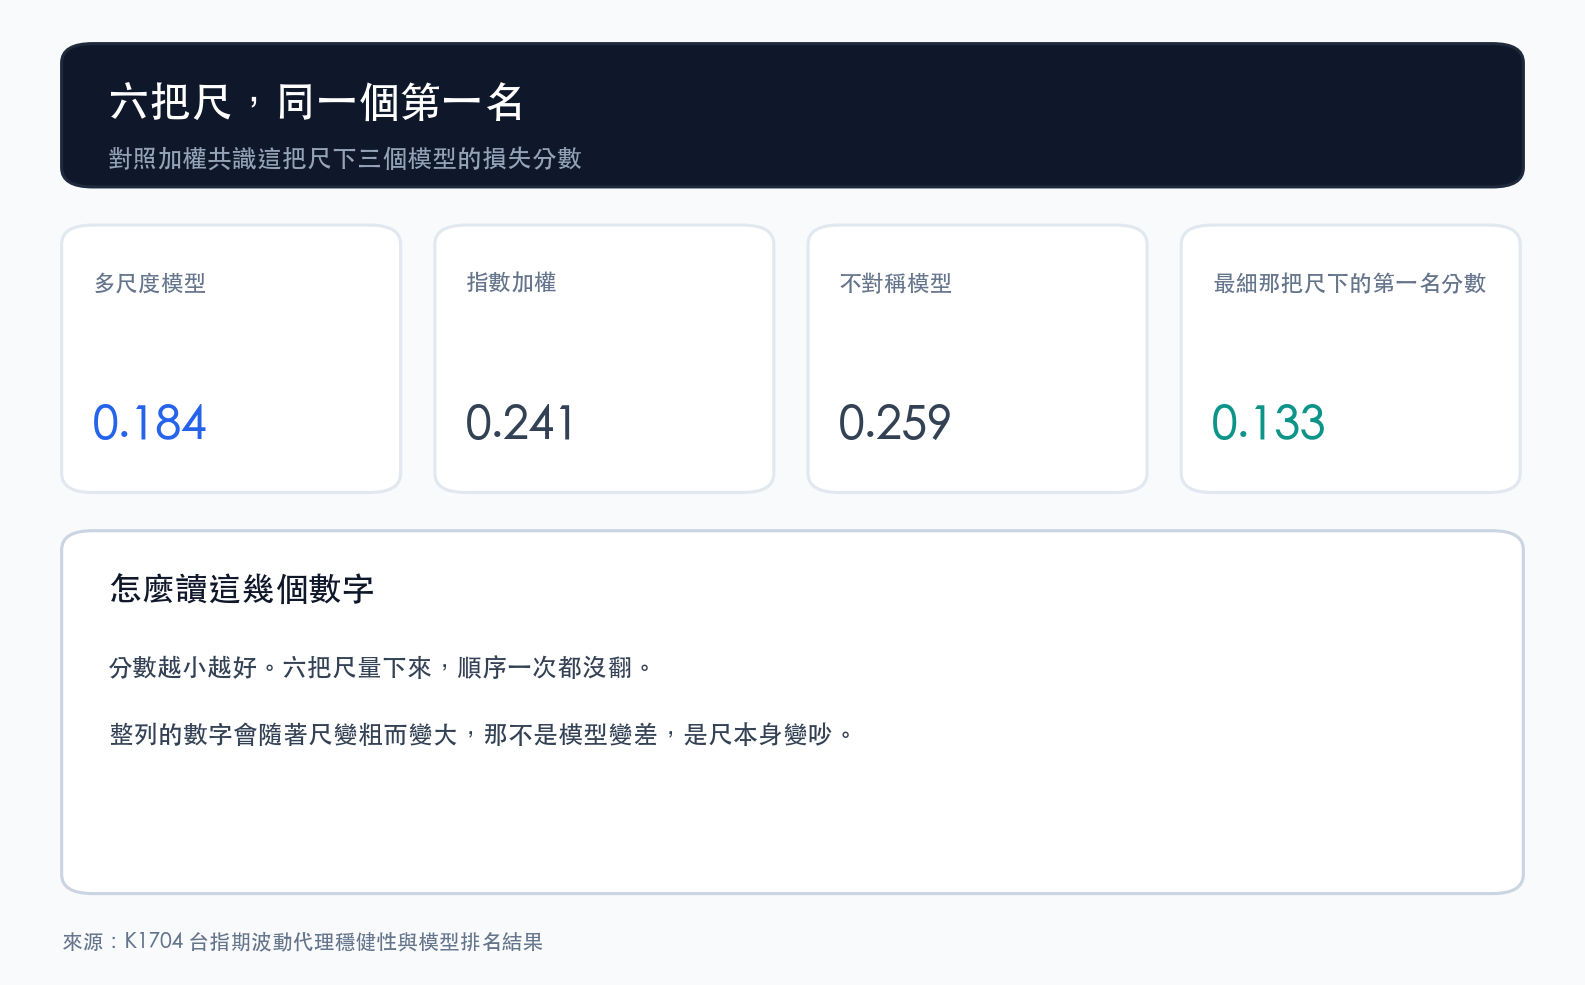
| 加權共識 | 0.1839 | 0.2405 | 0.2593 |
六列,同一個順序,沒有一列翻盤。
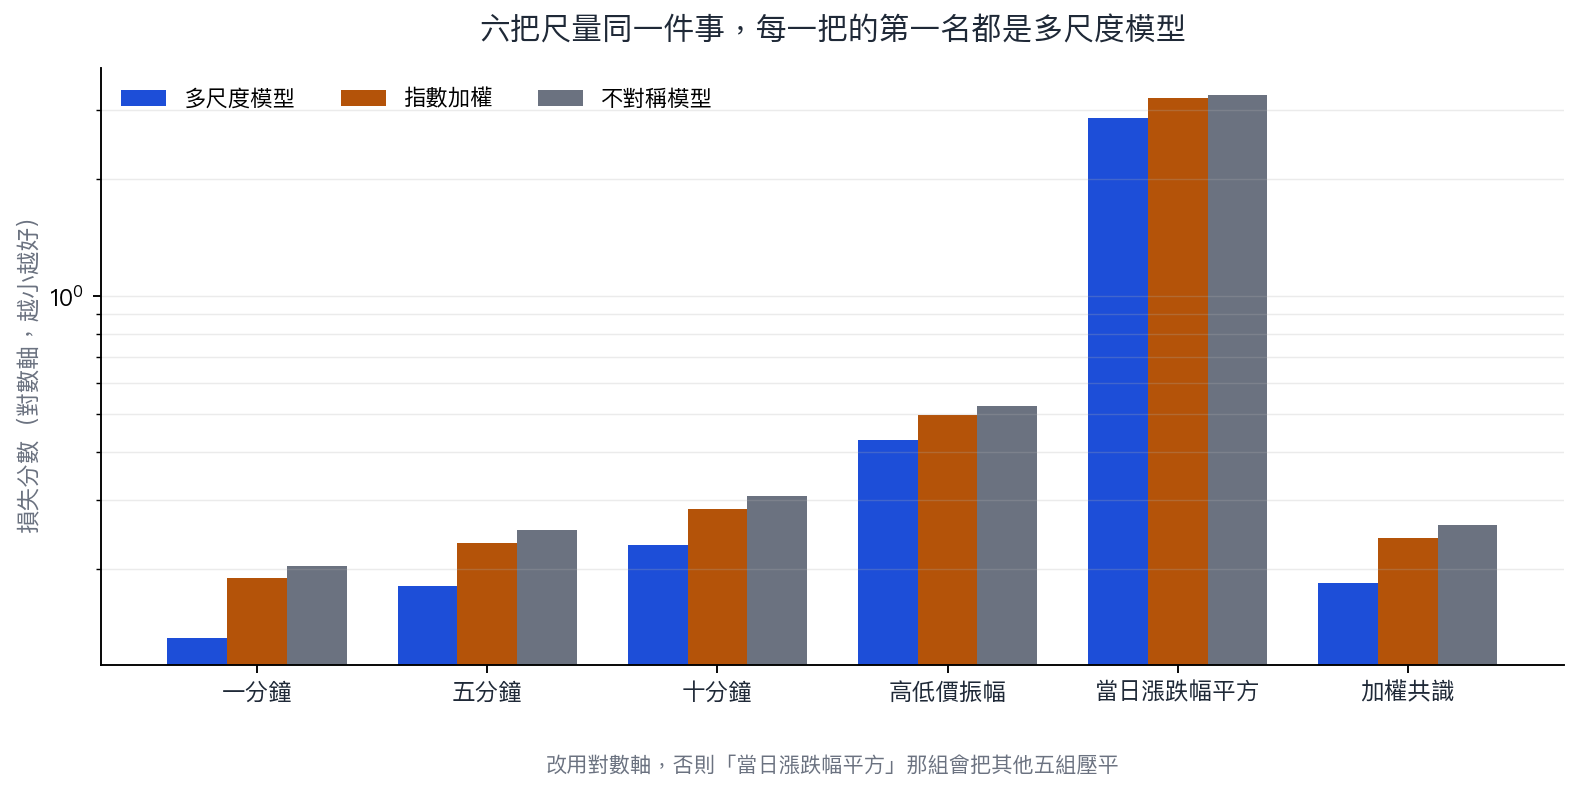
順帶可以看到一件事:整列的數字隨著尺變粗而整體變大。最細的一分鐘那列,最好的分數是 0.1335;最粗的當日漲跌幅平方那列,最好的也要 2.8573。這不是模型變差,是尺本身變吵,噪音進了分母。
再做一次淘汰賽
排名一致還不夠。名次可能只差一點點,差距在統計上不算數。
所以每一把尺都跑一次淘汰程序:重抽 1,000 次,把統計上撐不住的模型踢掉,看最後還剩幾個。
六次結果,剩下的名單每次都只有一個模型,就是多尺度模型。被淘汰的兩個模型,機率值落在 0.009 到 0.036 之間。
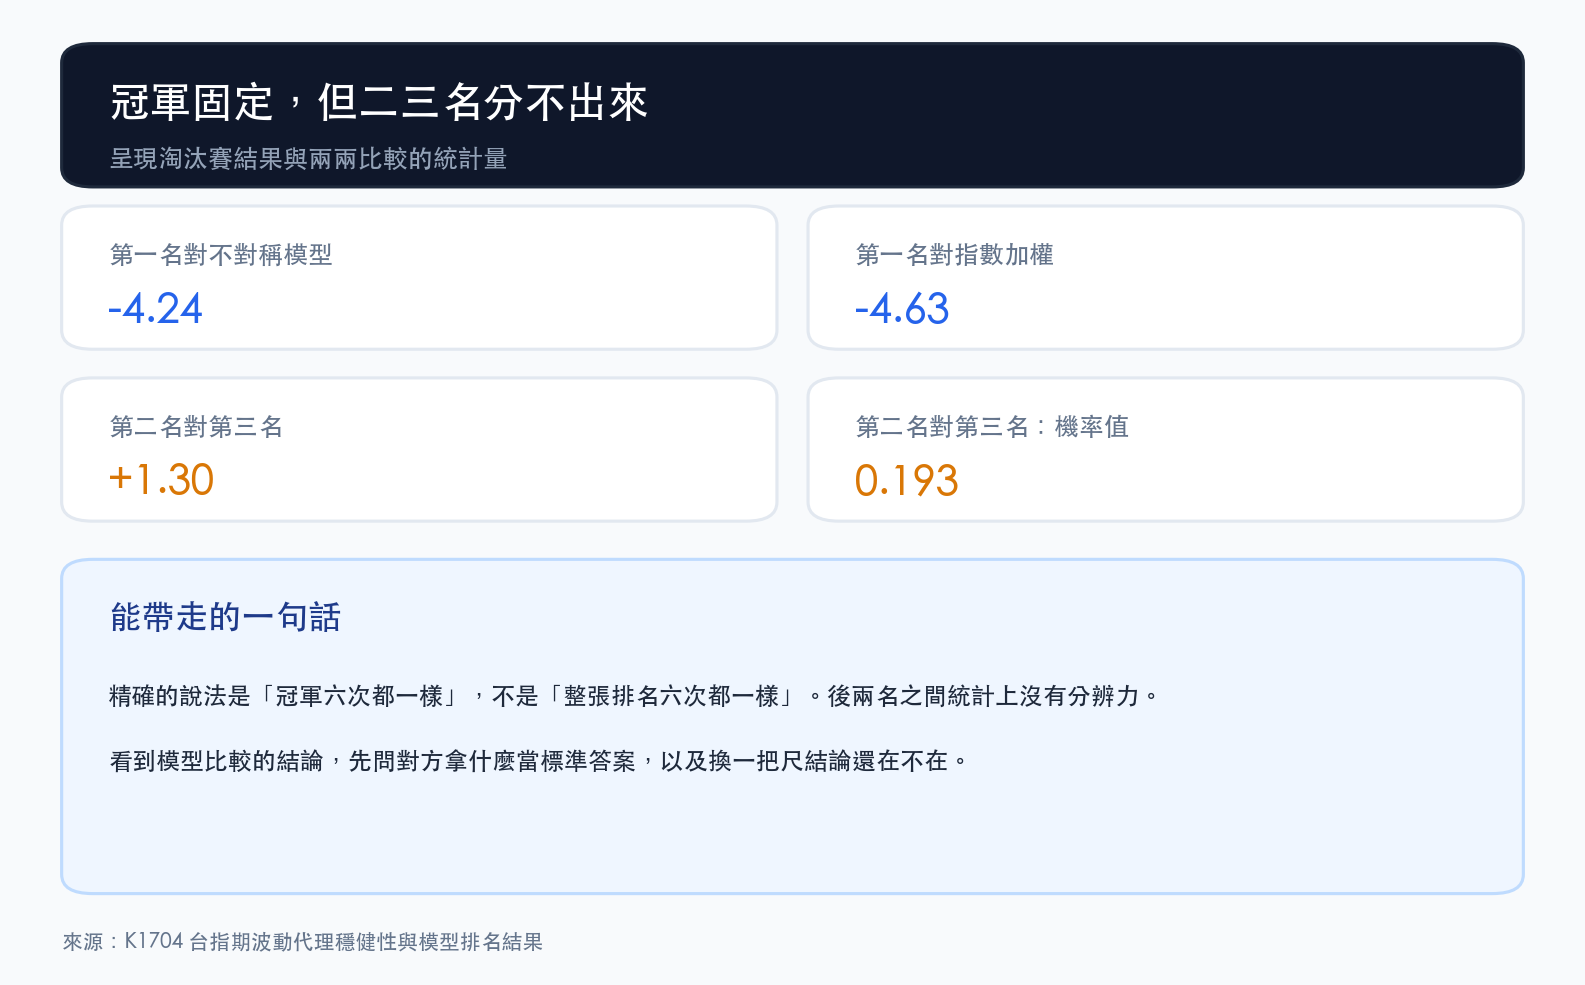
在共識這把尺上,把多尺度模型跟另外兩個各比一次:對上不對稱模型統計量 -4.24,機率值 0.0000231;對上指數加權統計量 -4.63,機率值 0.0000038。兩個都遠超過本平台採用的嚴格門檻。
但第二名和第三名之間分不出來:指數加權對上不對稱模型,統計量 1.30,機率值 0.193。
所以精確的說法是「冠軍六次都一樣」,不是「整張排名表六次都一樣」。後面兩名的相對位置雖然在每張表上看起來固定,統計上其實沒有分辨力。這一句得寫清楚,不然就是在用一個沒被檢定支持的順序講故事。
把驗收期切一半再試
八年半的驗收期可以藏很多東西。切成前後兩段各跑一次。
前段 2018 年 2 月到 2022 年 4 月,1,020 天。後段 2022 年 4 月到 2026 年 7 月,996 天。
兩段的排名一樣,淘汰賽剩下的也都只有多尺度模型。差別在「贏得多乾脆」:前段被淘汰者的機率值是 0.093,勉強擦過 0.10 這條線;後段是 0.061,比較穩。
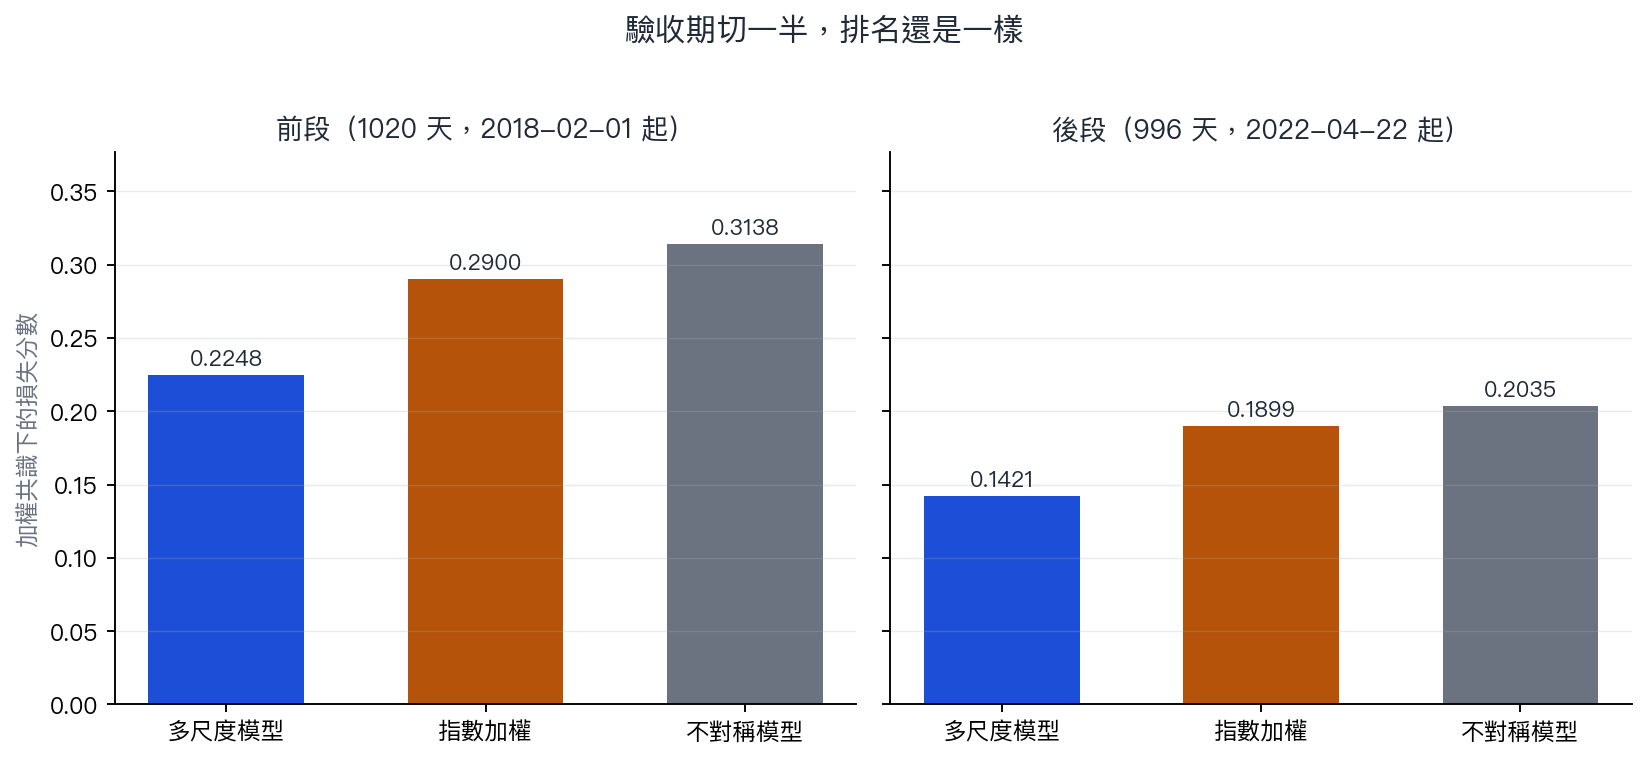
前段包含 2020 年那次崩盤。那段時間所有模型的預測都變爛,彼此的差距也被壓縮,所以淘汰得比較勉強。這個現象本身合理,但它也提醒一件事:這個結論在極端行情下的邊際比平常薄。
三個要說清楚的限制
共識那把尺的權重是憑經驗訂的,不是解出來的最優權重。真正的「市場那天到底抖了多少」永遠看不到,這裡只是用五個有偏誤的觀測去逼近它。
一分鐘、五分鐘、十分鐘這三把尺共用同一批逐筆資料,它們的誤差彼此相關。所以「六把尺一致」這句話的獨立性沒有表面上看起來那麼強,實際上比較接近「四把半」。
只研究了日盤。夜盤的結論不能從這裡推出去,那是另一個盤別、另一批參與者。另外,選合約的規則是取當天成交量最大的那個月份,這對盤後計算是合理的,但它用到了當天結束後才知道的資訊,不能拿去做日內交易。
這篇的用處
對讀者來說,可以帶走的是一個判斷習慣:看到「A 模型打敗 B 模型」的說法,先問對方拿什麼當標準答案,以及換一把尺結論還在不在。
這份研究的答案是:在台指期日盤上,多尺度模型的領先地位換六把尺都還在,切成前後兩段也還在。這不是一個新發現,是把一個舊結論放到壓力下再確認一次。壓力測試通過的結論,才有資格被後面的研究拿去當地基。
資料:本地台指期全合約逐筆檔案,取每日成交量最大的月份合約,僅日盤時段(上午八點四十五分至下午一點四十五分),不含跨盤別與轉倉報酬。樣本 2012-01-02 至 2026-07-14 共 3,548 個交易日,來源檔案逐檔複驗大小與內容雜湊全數相符。驗收期 2018-02-01 至 2026-07-14 共 2,016 個交易日,六個標準答案共用同一份日期帳本。損失分數採對低估懲罰較重的那一種;模型淘汰程序採平穩區塊重抽 1,000 次、顯著水準 10%;預測誤差比較採重疊窗口修正的標準誤。隨機種子 42。全文數字逐一對應實驗結果檔。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊