同一組模型,換個比較方式就從輸變贏:多出來的優勢有八成是基準讓出來的
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
模型比賽的結果,有時候不是由參賽者決定的,是由誰被派去當對照組決定的。
這件事在我們自己的一個波動率預測實驗上發生了一次,而且是我們自己犯的。
原本的比賽
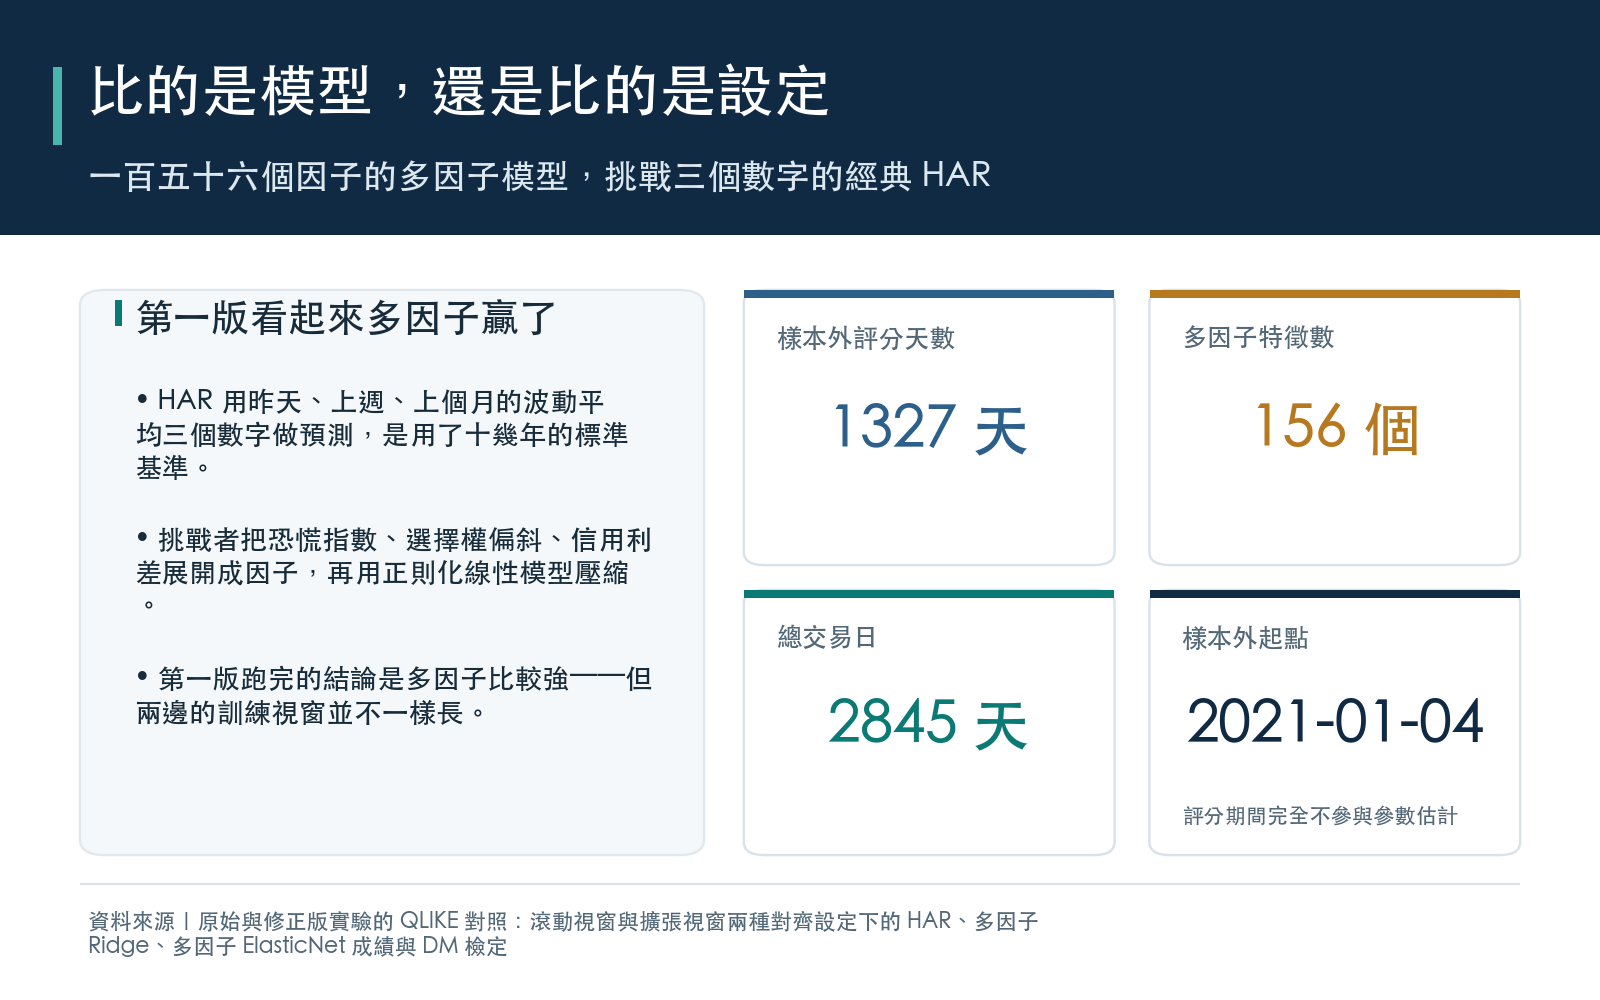
要預測明天的市場波動有多大,業界有一個用了十幾年的標準答案叫 HAR。它的想法很土:把昨天、上週、上個月的波動各拿一個平均,加權相加。三個數字,沒有機器學習,沒有神經網路。
近幾年有一批文獻主張,把更多資訊丟進去會更好,恐慌指數、恐慌指數的恐慌指數、選擇權偏斜、信用利差,全部展開成因子。這個實驗就是照這個路線做的:用一百五十六個因子,餵給兩種常見的線性模型(脊迴歸與彈性網),跟三個數字的 HAR 比。
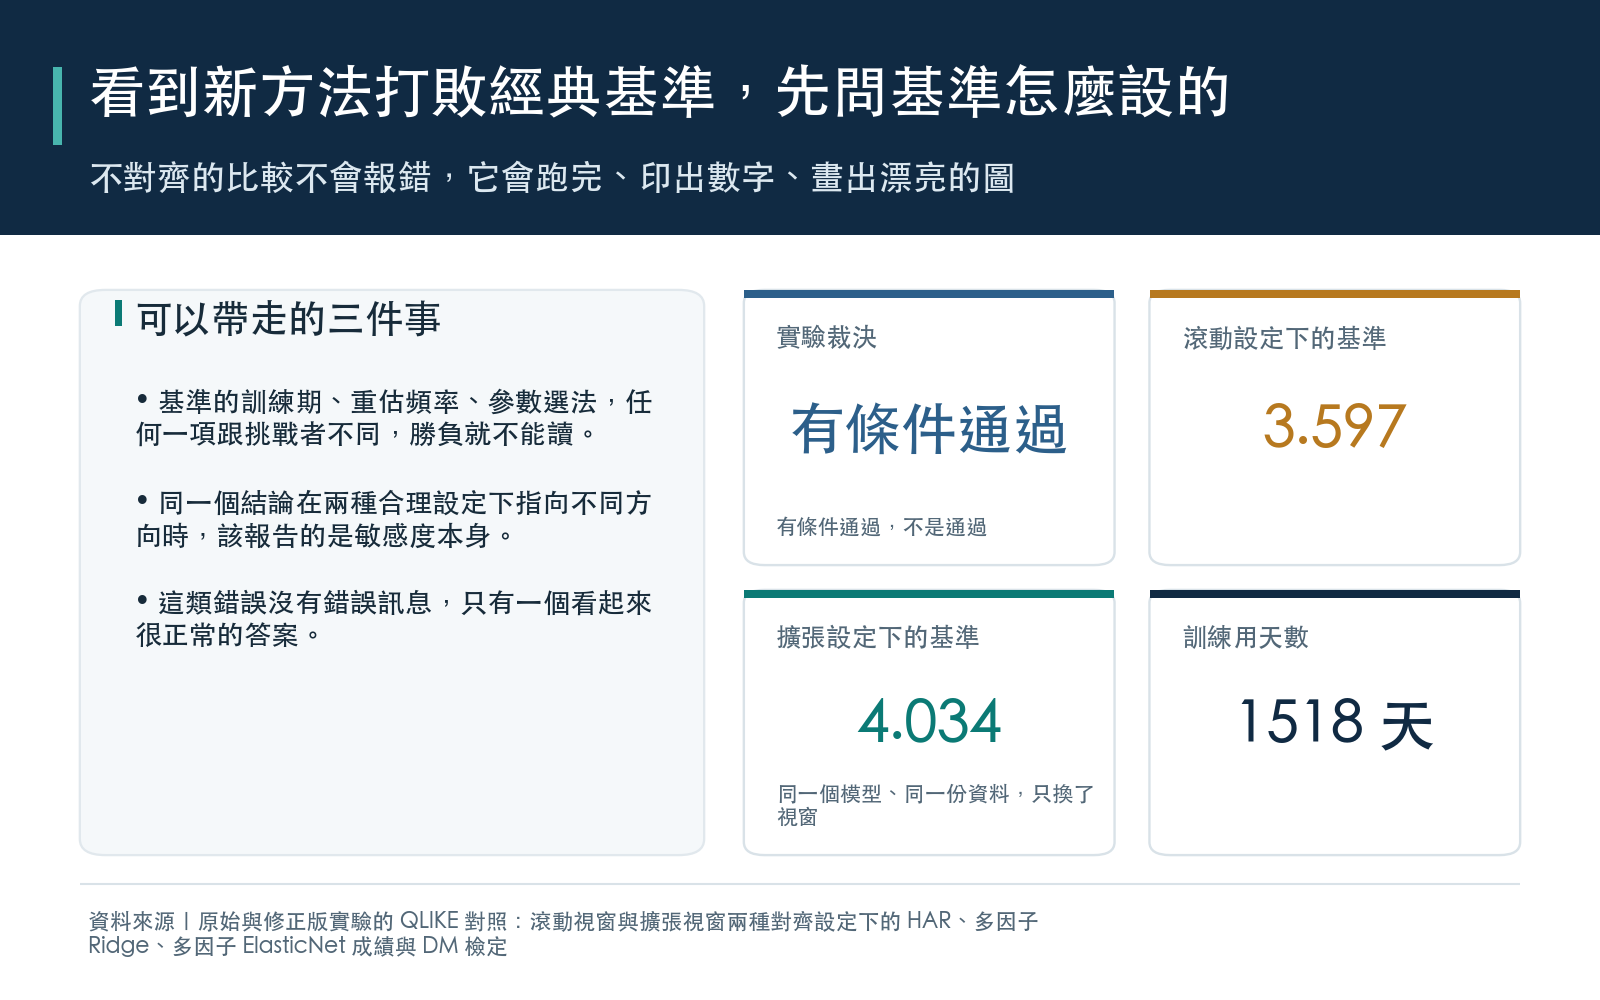
資料是 SPY 從 2014-12-22 到 2026-04-16,總共 2845 個交易日,其中 1518 天用來訓練,真正拿來評分的樣本外期間從 2021-01-04 開始,共 1327 天。
第一版跑完,多因子看起來贏了。
問題出在誰被派去當對照組
重跑的時候發現一件事:第一版裡,HAR 用的是滾動視窗,只看最近一千天,每個月重新估一次參數;而表現最好的那幾個多因子模型用的是擴張視窗,從頭到現在的資料全部拿來估。
兩邊訓練資料的長度不一樣。
這種不對齊很難在寫程式的時候看出來,因為兩邊各自都是合理的設定,沒有一行是錯的。錯的是把它們擺在同一張表上比大小。
修正版做的事很單純:把三個模型的視窗設定強制對齊,同一種設定跑一次,另一種設定再跑一次。兩張表,各自內部公平。
對齊之後的兩張表
評分用的指標叫 QLIKE,可以直接讀成「預測誤差分數」,數字越低代表預測越準。
| 模型 | 滾動視窗(只看最近一千天) | 擴張視窗(全部歷史) |
|---|---|---|
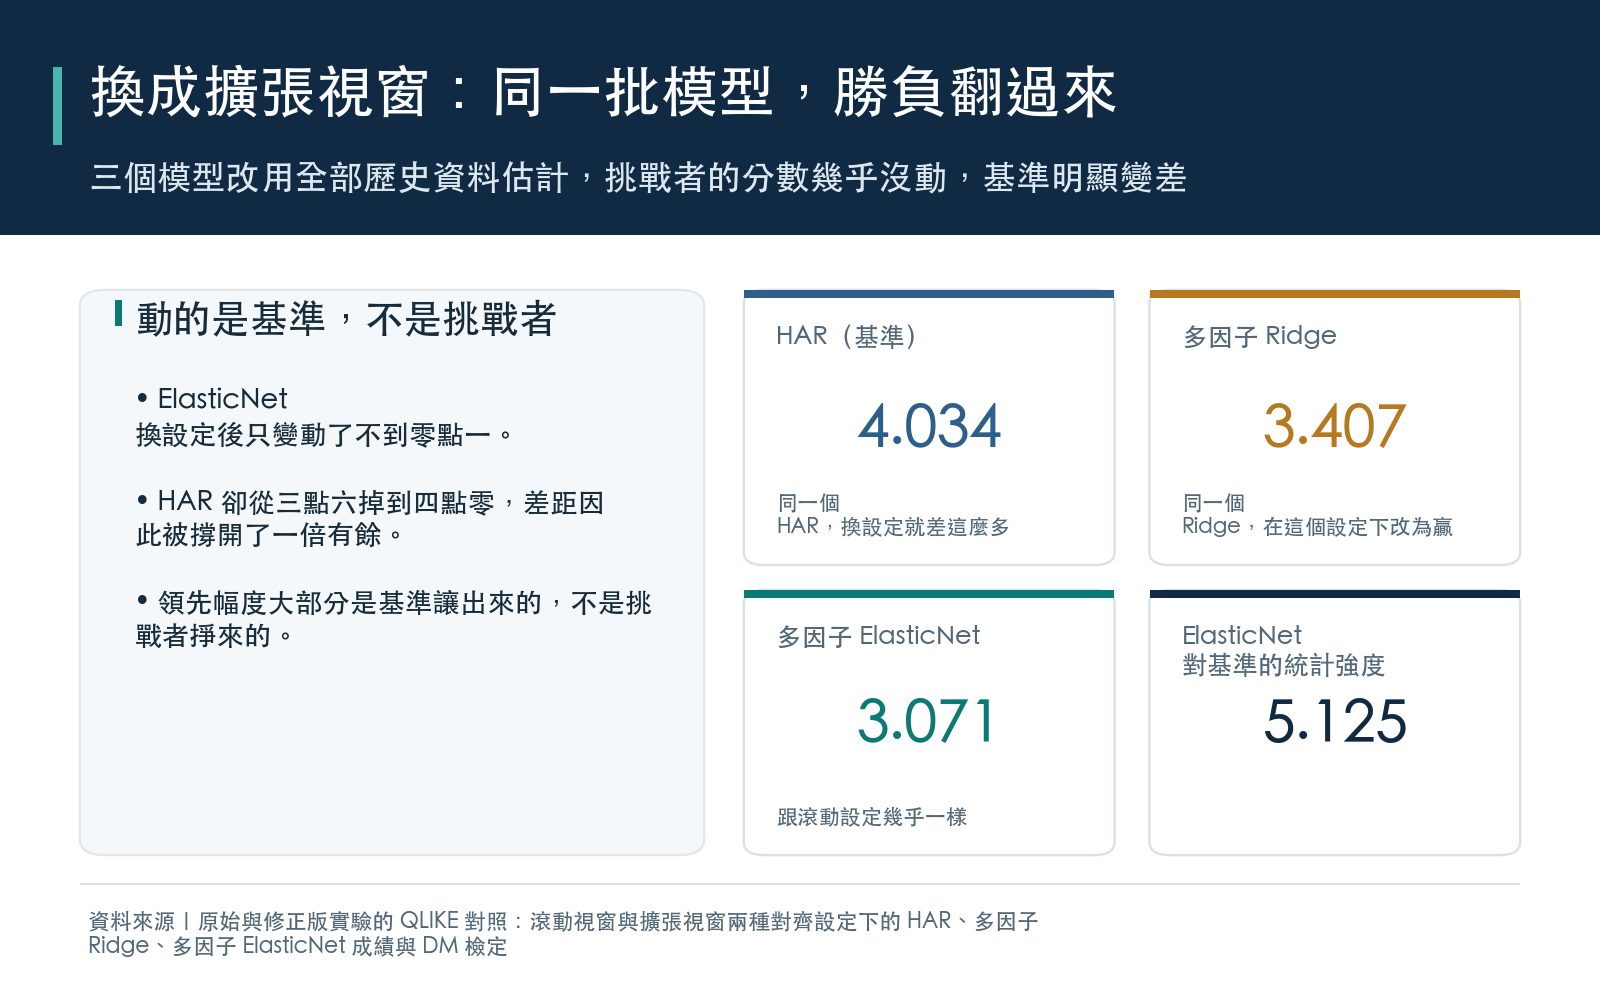
| HAR(三個數字的經典基準) | 3.5971 | 4.0342 |
| 多因子模型甲(脊迴歸) | 3.6218 | 3.4074 |
| 多因子模型乙(彈性網) | 3.1605 | 3.0714 |
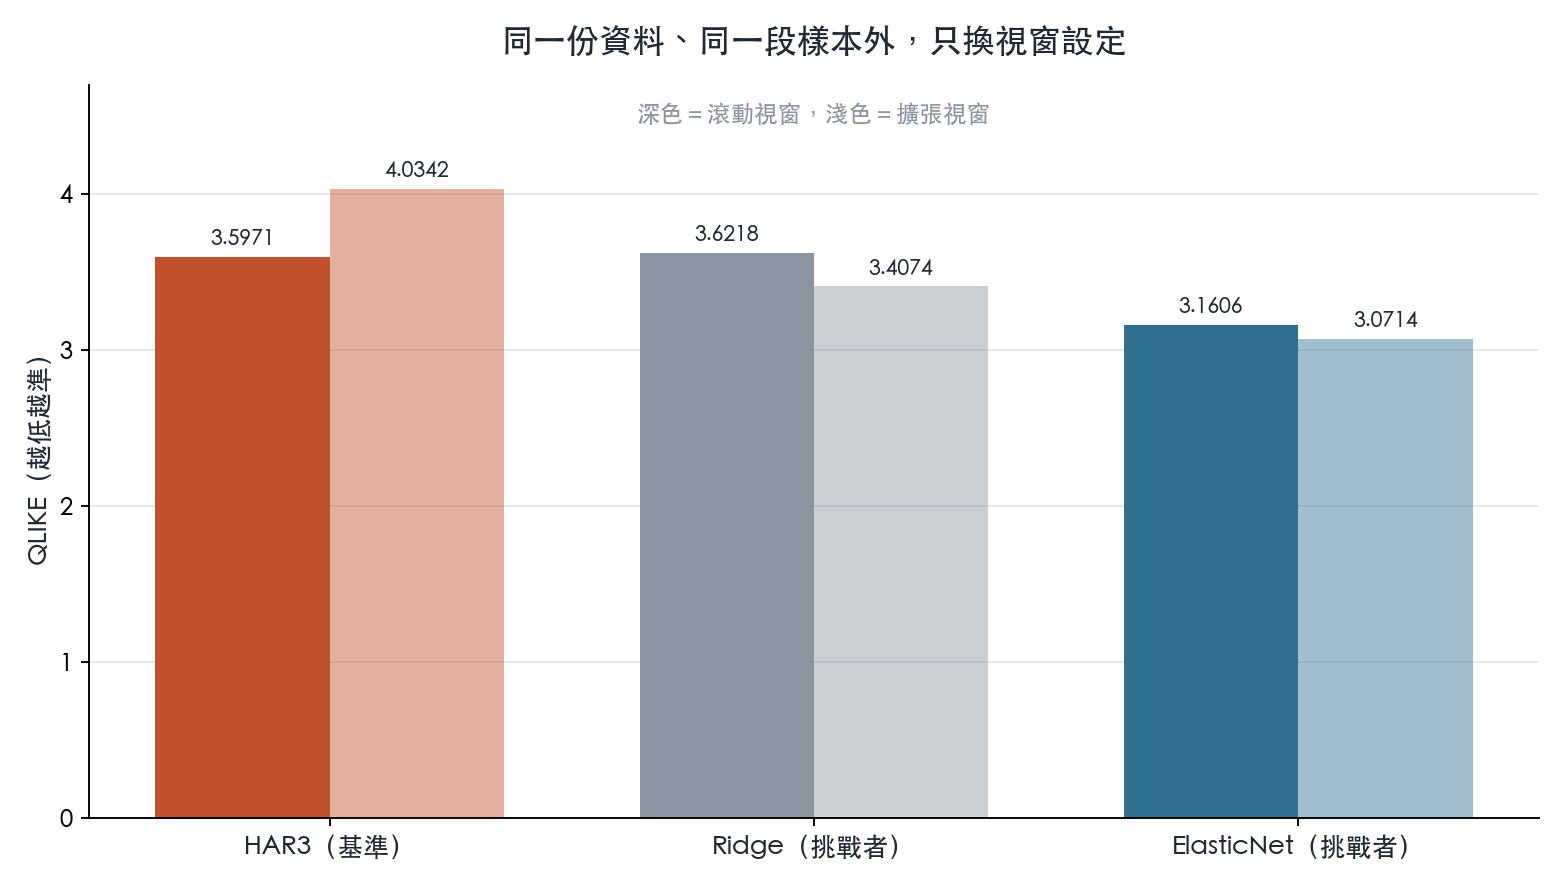
先看最下面那一列。彈性網這個挑戰者,換了視窗設定之後,分數從 3.1605 變成 3.0714。動了,但動得很小,小數點後第一位都還沒滿。
再看最上面那一列。HAR 從 3.5971 變成 4.0342。這個變動的幅度是挑戰者的好幾倍。
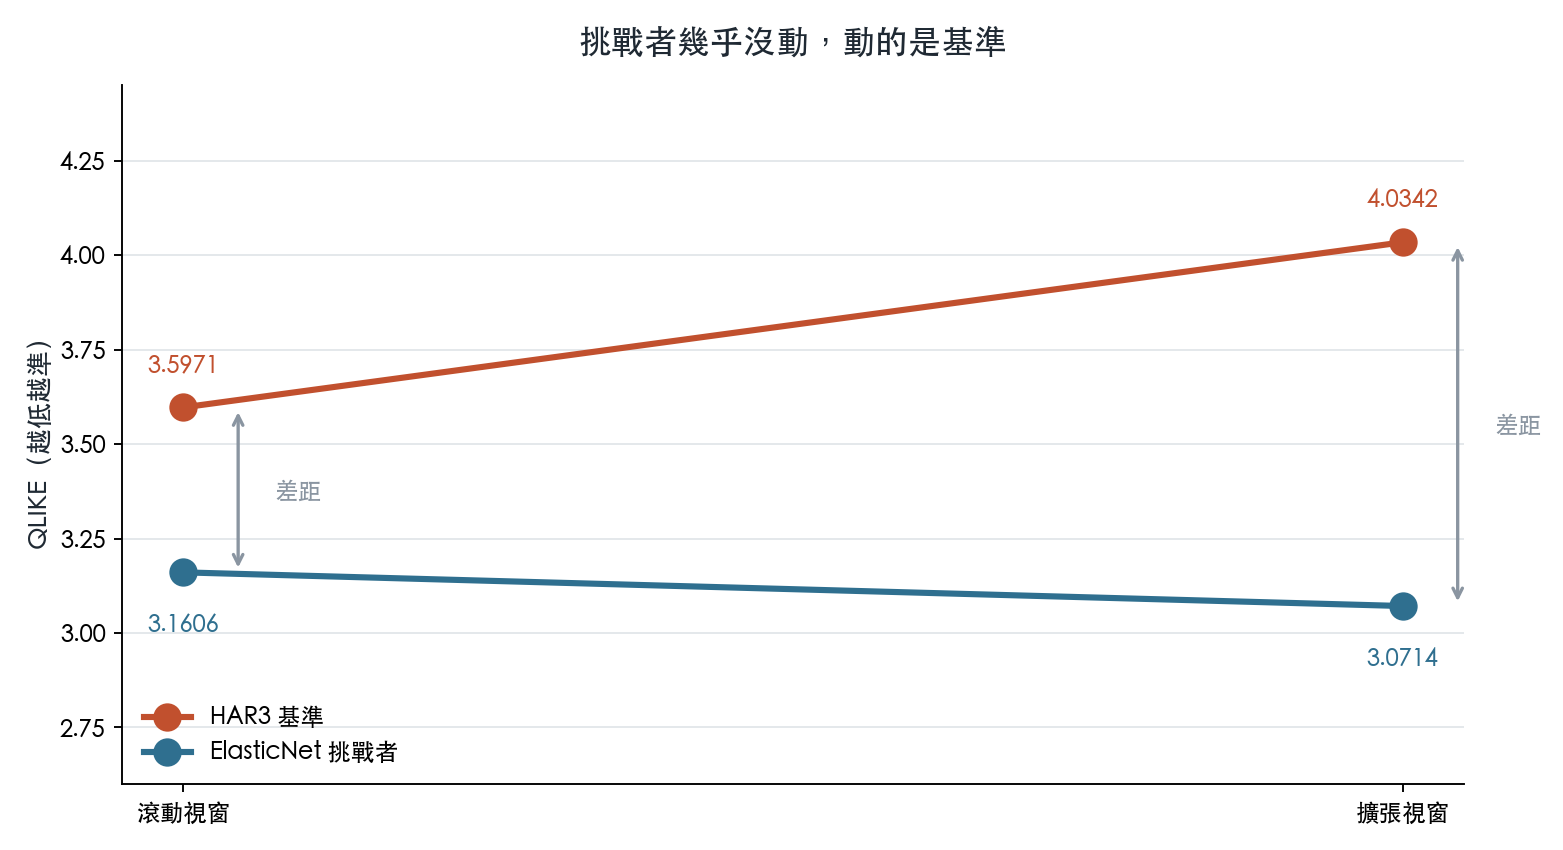
所以「多因子領先多少」這件事,主要是由 HAR 在哪個設定下被測量決定的,不是由多因子模型有多強決定的。第一版之所以看起來贏很多,是因為它剛好讓 HAR 站在對它最不利的位置上,用全部歷史資料估的 HAR,比只看最近一千天的 HAR 明顯差。
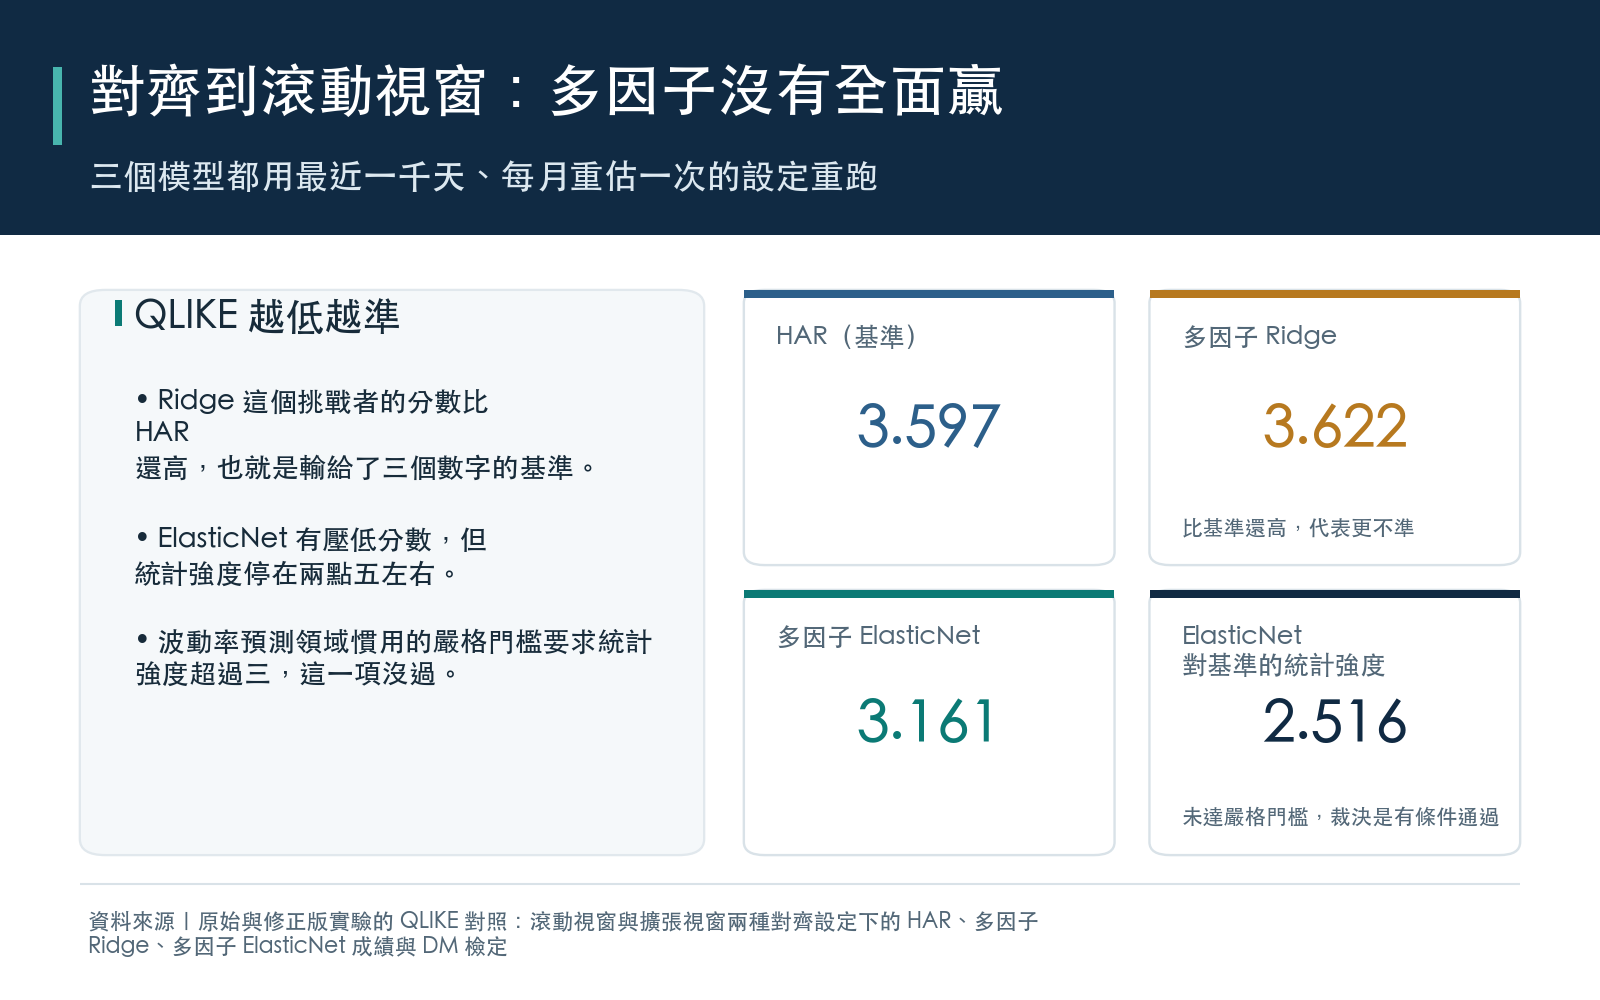
中間那一列還有更直接的證據:脊迴歸在滾動設定下的分數是 3.6218,比 HAR 的 3.5971 還高,也就是輸了。同一個脊迴歸,換到擴張設定就是 3.4074,贏過同設定的 HAR。同一個模型,同一份資料,勝負由對照組怎麼設定翻轉。
那多因子到底有沒有用
有一點,但沒有原本以為的那麼多。
對齊到滾動設定之後,彈性網對 HAR 的統計強度是 2.516。這個數字達到一般學術論文的顯著門檻,但沒有達到波動率預測這個領域慣用的較嚴格門檻(這個領域要求統計強度超過三,因為預測誤差在時間上會前後相關,用寬鬆的門檻會把顯著性算得太高)。
對齊到擴張設定,統計強度是 5.125,這個過了。脊迴歸在同一設定下是 2.766,一樣沒過嚴格門檻。
所以誠實的說法是這樣:在公開代理資料上,把因子展開再做正則化,有機會壓低誤差分數,但證據強度隨著視窗設定改變而改變,還不到「多因子模型確定優於 HAR」的程度。原始文獻用的是高頻資料算出來的因子,我們用的是日頻公開代理,本來就不是同一件事,這個實驗也不足以否定原文獻。
實驗最後給的裁決是「有條件通過」,不是「通過」。
這件事可以帶走的
第一,看到「新方法打敗經典基準」的結果時,先問基準是怎麼設定的。基準的訓練期、重估頻率、參數選法,任何一項跟挑戰者不一樣,那個勝負就不能讀。
第二,同一個結論在兩種合理設定下指向不同方向時,通常不代表其中一種設錯了。它代表這個結論本身就對設定敏感,那就該把敏感度一起報告出來。修正版兩張表都留著,就是因為只留一張都會誤導。
第三,這種錯誤不會報錯。程式跑得完,數字印得出來,圖畫得漂亮,誤差分數一路降。它是一個會回答案的裝置,只是那個答案回答的不是你以為的問題。
我們把第一版留在紀錄裡沒有刪掉,因為第一版和第二版擺在一起,才看得出差距是從哪裡跑出來的。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊